



AI動画がさらに最大で1.5倍速くなりました。MiniMax H3の現時点でローカル最速である3ステップの上に「スパースアテンション」を重ねることで。
きっかけは、かみもとさんによるXへの投稿でした。
ご本人によるNoteの解説記事も公開されました。
・【MiniMax H3】Jevを使ってAttention保持率を層ごとに切り替えて動画生成を高速化してみた(41%高速化)
MiniMax H3の高速化について何度も取り上げてきました。20ステップが4になり、4ステップが3ステップになり、毎晩走らせている生成動画の1本にかかる時間が128秒から59秒に。「もう削るところはないだろう」と思っていました。
その思い込みは外れました。まだ削るところはあったのです。
今回いちばん面白かったのは速さの数字ではなく、「どこで効いて、どこで頭打ちになるか」が8点測ったらきれいな式になったことです。
もう一つ、使い方の規則も見つかりました。速さは「詳しく書く」ことで買える……ただしあるものを書くという条件つきで。タイトルの「詳細記述スパース」はそのことです。
自分には使えないリポジトリ
かみもとさんの投稿からComfyUI-MiniMax-H3-W4A4-VSAというリポジトリにたどり着きました。名前のとおり、H3の重みと計算を4ビットまで落とし(W4A4)、さらにアテンションを疎にする(VSA)という、二段構えの高速化です。星も付いていて、実験ブランチまで動いている。
投稿にある「Jev」は、層ごとの間引き率を外部のLLMに決めさせる仕掛けです。50層あるうちの49層について、1%・3%・5%・10%の4択から選ばせる。生成の最中にクラウドへ問い合わせながら、それでも41.7%速い。リポジトリの記録では366.72秒が213.89秒になっています。
ここは公平に書いておきたいのですが、作者自身が続けてこう断っています。
ちなみに固定10%スパースでも結構速くなるので、一概にJevのみで高速化しているとも言えない点は注意。ただ、重要度をリアルタイムで判定してスパース率を変えられるので、固定方式よりは画質音質は良くなるはず。多分。
コードを公開した投稿にも、こう添えられています。
※実験ブランチです。動画の速度差はSparse Attention+Jev制御を合わせた効果です。
つまり速さの手柄はスパース化そのものにもあると、作者が最初から明記しています。そのうえでJevに期待しているのは「同じ速さでの画質・音質」のほうで、しかも「はず。多分」と留保が付いています。さらに別の投稿では、ステップ数そのものや「どの層を飛ばすか」までJevに決めさせてみたがうまくいかなかったので保留、とも書かれていました。超高速高機能なif文として使える、という応用のデモという位置づけです。
私がこれから書く「固定の間引き率だけでも速くなった」という結果は、作者の但し書きを別のハードで裏付けたものでもあります。
さて、うちで使えるのか。いつものようにClaude Codeに「調べて、使えそうなら入れて」と渡しました。返ってきたのは「どちらの経路も入口で止まります」でした。
ひとつめの経路(W4A4)は、かみもとさんが明記していました。
この検証版では native ConvRot INT4 は SM8x(Ampere/Ada)経路です。Hopper/Blackwell は対応対象から除外して停止します。
うちのRTX 5090はBlackwell世代です。この実測対象はRTX 4070。設計上、うちでは動きません。
ふたつめの経路(実験ブランチの目玉)は、4ビット変換が不要な代わりに、ComfyUIの新しい版に入っている「native SLA」というスパースアテンションを使います。うちのComfyUIは古い版で止めてあって、実際、必要なモジュールが存在しませんでした。
そしてもうひとつ、こちらは技術以前の問題で……その手法は生成のたびに外部のAPIを呼びます。送るのは指示文の本文と層の統計(重みや画像は送らない、と明記されています)。うちが作っているのは妻の写真とその動画なので、指示文が毎回そとに出る構成は、速さとは別の理由で選べませんでした。これは手法の欠点ではなくうちの都合です。費用の面ではかみもとさんが「20~30本作っても全然かからない」と書いていて、安さが理由で避けたわけでもありません。
たくさん生まれているローカル実装Jevクローンを使えば問題の回避はできるでしょうが。筆者もJevクローンは試していて、用途によってはそれなりの効果があることも確認しています。
というわけで、その日の収穫はゼロ……のはずでした。
「それ、手元にありますよ」
調べていたClaude Codeが、こう言いました。
手元の H3-Optimizations に、まさにそれ用の入力がありました。
8月27日に入れて、ワークフローには一度も繋いでいなかったノードです。当時のメモにはこう書いてありました。「スパースアテンションには品質の代償があると作者が明記している(プロンプト追従が落ちる・動きやディテールが変わる)。入れるなら測ってから」。そして半月、測定しないまま放置していました。
つまり、リポジトリを調べて「うちのComfyUIでは無理だ」と結論した機能が、別の人の実装として半月前から手元にあったわけです。使えないものを調べたおかげで、使えるものに気づいた。
スパースアテンションとは何なのか
動画生成モデルの中で一番コストが高いのは「アテンション」という仕組みです。乱暴に言えば、画面の中のあらゆる場所が、あらゆる場所に「あなたは私に関係ありますか」と聞いて回る処理です。空の一点が、地面の一点に聞く。1コマ目の左端が、150コマ目の右端に聞く。全部の組み合わせを計算します。
問題は、その数が要素数の2乗で増えることです。うちの「ソラリスの窓辺」は576×1344の158コマ。
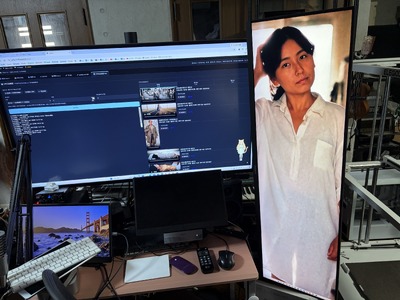
ソラリスの窓辺というのは、スタニワフ・レム原作、アンドレイ・タルコフスキー映画化の「惑星ソラリス」で、主人公の夢の中から抽出された亡き妻が実体として現れるというストーリーにちなんで作った我が家のシステムで、MiniMax H3で深夜に生成した動画が、我が家の大型ディスプレイで等身大で流れていくという仕組みです。うちはこれを毎晩、7本新規に走らせています。
圧縮された内部表現に直しても数万の要素があり、その2乗ですから、組み合わせは億の単位になります。ステップを減らしても、1ステップの中のこの計算は減りません。3ステップまで削ったのに頭打ちになっていたのは、ここが残っていたからです。
ただ、その問い合わせのほとんどは、ほぼ何も返していません。空の一点と地面の一点は、たいてい無関係です。ならば最初から聞かなければいい……というのがスパースアテンションです。
大事なのは、「雑に計算する」のではなく「計算しない」ことです。精度を落として速くするのではなく、組み合わせの大半を最初から捨てる。だから速くなり方が大きい。
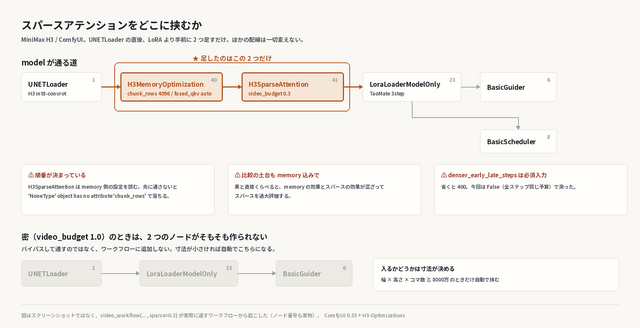
うちが使ったノードの入力は video_budget という数字ひとつで、0から1の間で指定します。1.0なら全部の接続を残す(=いままでどおり)。0.3なら3割だけ残す。作者の説明によれば、間引かれるのは「映像どうし」の経路だけで、指示文・音声・参照画像といった外からの条件や、境目にあたる部分は密のまま残ります。人物が誰かという情報や、口を動かす音は、細らせない設計になっているわけです。
そして、このノードにはもうひとつlayer_video_budgetsという入力がありました。H3の50層それぞれに別の予算を配れるというものです。今回は使っていませんが(全層に同じ数字を入れただけです)、層ごとに感度が違うのは当たり前なので、ここはまだ余地が残っています。冒頭のリポジトリが外部LLMにやらせようとしていたのも、まさにこの配分でした。
2カ所でつまずいた
配線でつまずいた点を書いておきます。どちらもエラーメッセージが正直だったので、すぐ分かりました。
ひとつめ。メモリ最適化のノードを先に通さないと落ちます。スパースのノードが内部でメモリ側の設定を読むので、繋いでいないとNoneを触って止まります。
ふたつめ。これは測り方の話ですが、比較の土台も「メモリ最適化込み」にしないといけません。そうしないと、メモリ最適化ぶんの速さとスパースぶんの速さが混ざって、スパースを過大評価します。
実測:効きは「トークン数」だけで決まる
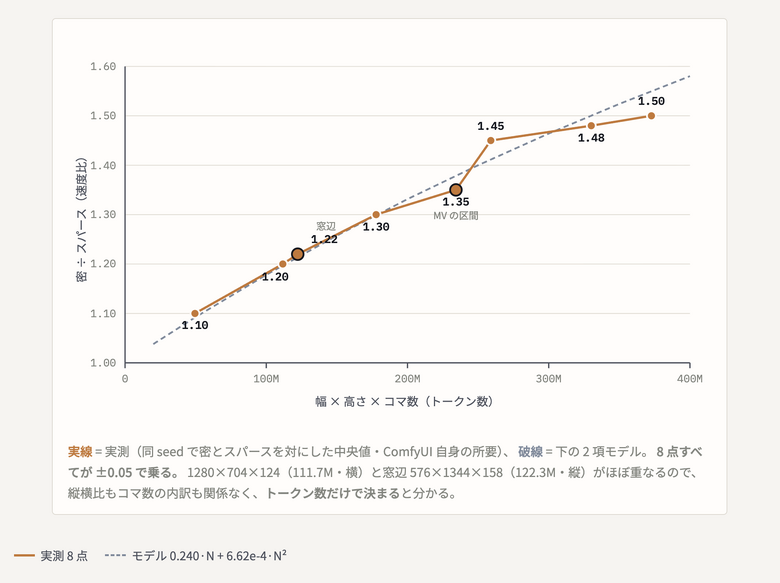
結論から書きます。効きを決めているのは解像度でも縦横比でもコマ数でもなく、その積(幅 × 高さ × コマ数)だけでした。
同じシードで密とスパースを対にして、8つのサイズで測ったのがこれです。秒はComfyUI自身が記録した実行時間です。
トークン | サイズ × コマ | 密 | スパース0.3 | 比 |
|---|---|---|---|---|
49.5M | 832×480×124 | 14.4秒 | 13.1秒 | 1.10倍 |
111.7M | 1280×704×124 | 36.2秒 | 30.1秒 | 1.20倍 |
122.3M | 576×1344×158(ソラリスの窓辺) | 33.3秒 | 27.4秒 | 1.22倍 |
177.8M | 1600×896×124 | 75.9秒 | 58.2秒 | 1.30倍 |
234.3M | 1280×704×260(MVの区間) | 95.2秒 | 70.7秒 | 1.35倍 |
259.0M | 1920×1088×124 | 111.6秒 | 77.2秒 | 1.45倍 |
330.1M | 1920×1088×158 | 131.2秒 | 88.9秒 | 1.48倍 |
372.7M | 1600×896×260 | 158.8秒 | 105.5秒 | 1.50倍 |
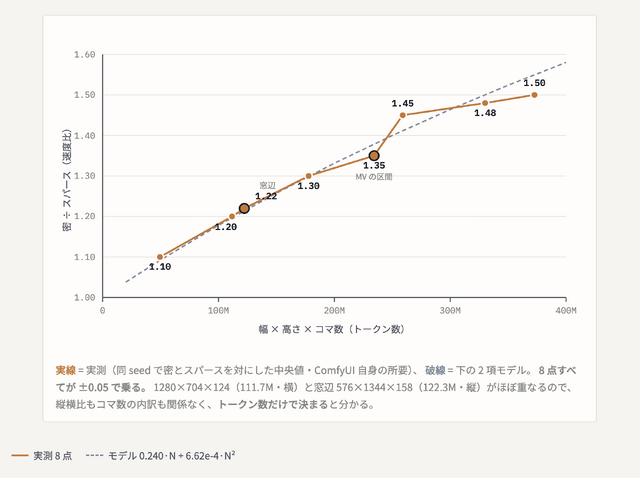
トークン数の順に、比がきれいに、単調に並びます。
いちばん効いているのは3行目と2行目の比較です。1280×704の124コマ(横長・111.7M)と、576×1344の158コマ(縦長・122.3M)。縦横比も逆、コマ数も違う。それなのに1.20倍と1.22倍でほぼ同じでした。
ついでに、いちばん小さいサイズでの注意を書いておきます。うちの「対話の口」は640×352で、ここでは入れても入れなくても同じでした(トークン35.6M)。
「対話の口」は、MiniMax H3 で妻のアバターの返答映像を作る試作システムで、返事が返るまで8~14 秒。セリフと声は別マシンが担当し、H3 はしゃべる映像だけを作ります。
小さい絵で試すと「効かない機能だ」と誤認することになります。
なぜ3.33倍にならないのか
予算0.3なら、アテンションの計算は3割になります。単純に考えれば3.33倍速くなってもいいはずです。実際には本番のサイズで1.35倍。この差はどこから来るのか。
8点を素直な式に当てはめたら、±0.05で全部乗りました。
密にかかる時間(N) = 0.240 × N + 0.000662 × N²
↑MLP・射影・VAEデコード ↑アテンション
(Nは100万トークン単位)
第1項はトークン数に比例する部分。第2項が2乗で増えるアテンションです。実測した削減量はN の1.89乗に比例していて(理論値は2.0)、係数は7.5倍の範囲で±14%に収まりました。
スパースが削れるのは第2項だけです。だから比は「アテンションが全体の何割を占めているか」で決まります。
アテンションの取り分 | 比 | |
|---|---|---|
ソラリスの窓辺 122.3M | 25% | 1.22倍 |
MVの区間 234.3M | 37% | 1.35倍 |
372.7M(測定の上限) | 48% | 1.50倍 |
アテンションが計算時間の半分になるのは、N = 363M からという計算になります。実測の372.7Mで48%ですから、ちょうど合っています。
つまり……私たちが普段作っているサイズでは、アテンションはまだ律速ではなかった。時間の3~4割しか食っていないものを3割に間引いても、全体は1.35倍にしかならない。ステップ数を減らす高速化があれだけ効いた(20→4→3)のに対し、スパース化が控えめなのは、残りの6割がMLPや射影やVAEデコードだからです。
この式で外挿すると、500Mで1.68倍、4K相当(3840×2160×124コマ=1029M)で2.06倍、無限に大きくすれば3.33倍に近づきます。ただし外挿は測っていない領域の話なので、そのつもりで読んでください。
ハードの天井のほうが先に来た
「じゃあもっと大きい絵で測ればいいじゃないか」……そう思って実際にやったのですが、ここで別の壁に当たりました。
メモリです。 1600×896の124コマを作っている時点で、WSLで設定しているシステムRAMの使用量が44GB(積んでいるのは47GB)に達していました。次の段(1920×1088)は画素数が1.45倍。そのままでは足りません。
WSLへのメモリ割り当てを48GB→58GBに上げて(ホストPCは63.6GB積んでいます)、ようやく372.7Mまで測れました。上の表の下3行は、その結果です。
⇒ 律速していたのは5090の32GB VRAMではなく、ホストのRAMでした。 スパースアテンションが本領を発揮するサイズに入る前に、そちらが天井になるというわけです。
リップシンクは壊れないのか
うちにとって一番こわいのは、口が合わなくなることです。MVは歌っている顔が主役なので。
ただ、**口パクが合っているかどうかは、目で見ても分かりません。**口が動いている映像としゃべっている音声を並べると、どの組み合わせでもそれなりに合って見えるからです。どちらにもリズムがあり、間があり、開いて閉じる。
なので専用の物差しを持っています。口の開き(内唇の縦÷口の幅)と、音声から起こした母音の期待開きの相関を取る——ここまでは普通ですが、そのあとにわざと間違えた組み合わせを作ります。1本目の映像に3本目の音声、2本目に5本目の音声、という具合に。自分以外の5本から選ぶので 5⁶=1万5625通り。その全部で同じ採点をすると、「中身が無関係でも偶然これくらいは合ってしまう」という点数の山ができます。これが帰無分布です。
正しい組の点数がその山の上位5%より外に出れば、偶然では説明がつかない——本当にその音で口が動いている。埋もれたら、口が動いていても合っているとは言えない。
この物差しが要ることは、実際に痛い目に遭って分かりました。以前、別のモデル(LTX)で「口が開いたコマを毎回の参照画像にする」という手当てを試したとき、口の開きは0.155→0.206と明らかに大きくなったのに、相関は帰無の5%点より下に落ちたのです。口が開きっぱなしになり、閉じる時刻が音と噛み合っていなかった。目で見ると「よく動いている」としか見えませんでした。
640×352・6本・同じシードで、
密 | スパース0.3 | |
|---|---|---|
全コマ | +0.208(帰無の外) | +0.171(帰無の外) |
発声コマだけ | +0.161(6/6) | +0.168(6/6) |
口の大きさ | 0.154 | 0.143 |
どちらも帰無分布の外に出ました。発声中の相関はほぼ同じ。全コマは少し下がっていますが、シード1本ぶんなので「差」とは言えません。
つまり口パクのサイズでは、速くもならない代わりに、壊れもしない。入れても入れなくても同じ、というのが結論でした。
代償は「劣化」ではなかった
さて、作者が警告していた代償の話です。
同じシード・同じ指示で予算だけ変えると、画素の差が25.8~27.9(255段階)出ます。前日に測った別の高速化(VAEの量子化)の差が1.7でしたから、桁が違います。
でも、1枚ずつ見ると全部まともなのです。破綻もぼやけもない。人物も一貫している。
何が起きているかというと……書いていないところで、別のくじを引くことになります。
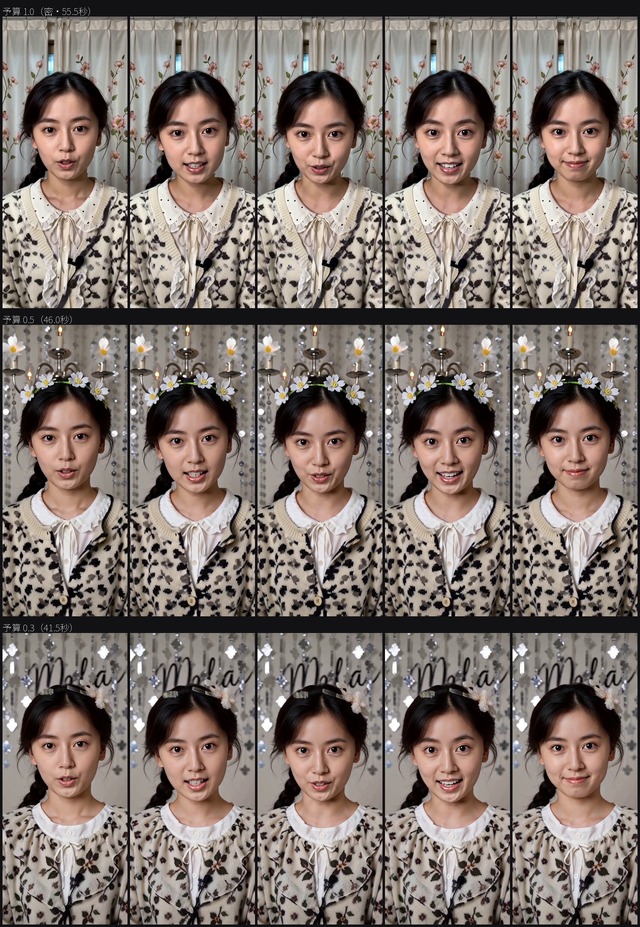
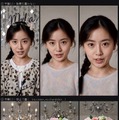
▼作例(予算1.0 / 0.5 / 0.3)
私の試験用の指示文は「若い女性がカメラに向かって話す・カメラ固定・柔らかい光」だけで、背景を一言も書いていませんでした。その状態で予算を下げると……、
予算1.0:花柄のカーテン、髪に何もなし
予算0.5:花冠が生え、シャンデリアとビーズの簾
予算0.3:髪飾りが生え、背景に「Mola」という文字が出る
理屈は付きます(ここは私の読みで、確かめたわけではありません)。間引かれているのは「映像どうしが打ち合わせる」経路です。画面の離れた場所どうしが「君は何を描くの、じゃあ僕はこう描く」と擦り合わせる、その回線が細くなる。指示文で内容が決まっている場所は、条件のほうから答えが来るので影響を受けない。決まっていない場所は、擦り合わせが薄いぶん、その場その場で埋められる……という形に見えます。
では、書けばいいのか
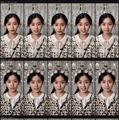
そこで、要素を8つ名指しした指示文で測り直しました。赤いセーター、青い花瓶、黄色いひまわり、両手で開いた本、窓の雨、縞のオレンジ猫、緑のスタンド、木のテーブル。
予算1.0・0.5・0.3 × 3つのシードで9本作って、9本とも8つ全部が出ました。一つも落ちませんでした。
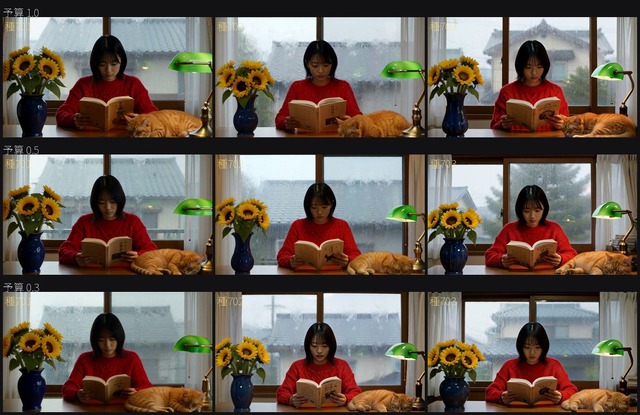
▼作例(8要素・予算3段階)
名指しで書いたものは、予算を3割まで落としても残る。速さは「具体的に書く」ことで獲得できるわけです。
「禁止」で書いてはいけない
「では背景を指定すれば髪飾りも消えるはずだ」と考えて、こう書き足すとどうなるか。
頭には何も着けない。冠も花もヘアバンドも無い。背景は一面の淡い灰色の壁で、カーテンもシャンデリアもビーズも文字も飾りも一切無い。
結果は……3本とも、花冠とシャンデリアが出ました。しかも今までで一番豪華なやつが。
理由ははっきりしています。MiniMax H3はCFGを使わない(cfg 1.0)ので、ネガティブプロンプトがそもそも評価されません。「冠は無い」と書くと、モデルには「冠」という単語を渡したのと同じに届く。
これは私たちが以前にも踏んだ罠でした。窓辺の動画で「寄るな(no zoom)」と書いても効かず、「顔が全部入る・左右に余白がある」とあるべき姿を名指しで書いたら直った、という記録がメモに残っています。同じ法則が、別の場所でもう一度出てきたわけです。
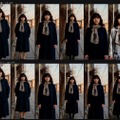
書き直すとこうなります。
髪は三つ編みで、何も着けていない。背景は一面の滑らかな灰色のコンクリート壁が端から端まで。無地の紺のセーター。
3本とも、指定どおりになりました。予算0.3のままで。
「詳細記述スパース」
この使い方に名前が要ると思いました。速さそのものより、使いこなしの規則が名前になっているほうが役に立つからです。
規則はこうです。書いたものは残る。書かなかったものは流れる。
なので 「詳細記述スパース」 と呼ぶことにします。予算を下げるほど、指示文の詳しさがそのまま画面の安定性になる。裏返せば、適当に書いた部分から順に失われていく。速さと引き換えに差し出しているのは画質ではなく、「書かなかった自由」のほうなのです。
ただし「詳しく書く」だけでは足りません。条件がもう一つあります。あるものを書くこと。無いものを書いてはいけない。前の節で失敗した「冠も花もヘアバンドも無い。カーテンもシャンデリアもビーズも文字も飾りも一切無い」は、字数で言えば十分に詳細です。それでも逆効果でした。詳しさと、肯定文であること。両方そろって初めて効きます。
うちのメモにはもともと「書かないものは保たれない」という一行があります(人物の説明を2本目以降に書かなかったせいで、動画の後半が別人になった事件から来ています)。詳細記述スパースは、その法則を増幅する装置だと言えます。
分散では使わない
窓辺とMVの本番に組み込みました。入れるかどうかはサイズが決めます……幅×高さ×コマ数が8000万を超えたときだけ自動で入る、という門を置いてあります。対話のサイズでは入っても無駄なので、入りません。
ただしひとつ例外を作りました。MVを複数マシンで分担するときは、スパースを切ります。
うちのMVは、RTX 5090(Windows 11 + WSL2 Ubuntu)とRTX 4090(Windows 11)で区間を分け合って作ります。ところがこのスパースのノードは、4090では動きません。
4090側は24GBに収めるためモデルを量子化(GGUF)して使っていて、ノードが行列の形を読み違えて落ちるのです。4090側のClaudeが対照実験までして確認してくれました……密なら145.3秒で通るのに、ノードを挿した2通りはどちらもエラーで即死する、と。
片方だけスパースにすると、同じMVの中で「書かなかったところ」の描かれ方が区間ごとに変わります。名指しした要素は両方に残るので人物や小道具はぶれませんが、背景の細部がワーカーの境目で切り替わる。
速さ(区間あたり25秒)より、絵の揃うほうを取りました。分担するときは両方ともスパースを使わず、密で作ります。
期待したほどではないが
言えること。 5090で、ソラリスの窓辺の1本が33.3秒→27.4秒(1.22倍)、MVの区間が95.2秒→70.7秒(1.35倍)。名指しした8要素は予算0.3でも9本中9本で保たれ、リップシンクは帰無分布の外に残りました。これはTaoMateの3ステップLoRAを使った上での話なので、前回の到達点を置き換えではなく積み増しで超えたことになります。
言えないこと。 「◯◯より速い」は言いません。他所の数字は違うハードで測られたもので、同じGPU・同じ解像度・同じ尺・VAEデコードまで含めた実時間で並べないと順位は決まらないからです。
そして今回いちばん正直に書いておきたいのは、期待したほどは速くならなかったということです。アテンションを3割に間引いて、本番で1.35倍。理論上の3.33倍には遠い。その理由まで式で説明できたのが今回の収穫で、数字そのものは地味です。
残りの6割はどこにあるのか、測ってみた
「では残りの6割はどこか」。式が指しているだけでは足りないので、測りました。段数を1・2・3と振れば、「サンプリングの外」と「1段あたり」に割れます。
所要(段数) = C + 段数 × S
同じシードで2本ずつ、ComfyUI自身の実行時間で:
式 | サンプリングの外 | サンプリング | |
|---|---|---|---|
窓辺 122.3M | 13.3 + 段×6.5 | 13.3秒(41%) | 19.5秒(59%) |
MVの区間 234.3M | 31.6 + 段×16.3 | 31.6秒(39%) | 48.8秒(61%) |
別々のサイズで、4割と6割にそろいました。
さらに、スパースが削る量(MVで24.5秒)から逆算すると、サンプリング48.8秒のうちアテンションが約35秒。残りがMLPと射影で約14秒=全体の17%です。
つまり、私が最初に並べた「MLP・射影・VAEデコード」のうち、MLPと射影は合わせて17%しかありませんでした。いちばん大きい非アテンションの塊は、サンプリングの外の4割のほうです。その正体はほぼVAEデコードと見ています(窓辺のC=13.3秒に対し、以前デコードだけを測ったときが同じ桁でした)。重みの読み込みとテキスト符号化は、モデルが載りっぱなしなのでほとんど無料です。
MVの区間の時間配分は、最終的にこうなりました。
割合 | ||
|---|---|---|
アテンション | 44% | ← 今回3割に間引いた |
VAEデコード中心の「サンプリングの外」 | 39% | |
MLP・射影 | 17% |
① VAEデコード(39%) ⚠ うちが持っている手は、両方とも効きませんでした。Fast VAE Decodeは差0.3秒、映像VAEのint8版は逆に2.7秒遅い。新しい実装を待つしかありません。
② MLP・射影(17%) W4A4(重みも活性も4ビット)なら効きますが、いまの実装はAmpere/Ada向けでBlackwellは対象外。動くようになれば、ここに効きます。
③ アテンションをもっと間引く ——ここが一番現実的かもしれません。うちはvideo_budget 0.3、つまり3割を残しています。一方あちらの詳細解説を読むと、層ごとの保持率は1%・3%・5%・10%。桁がひとつ違う。しかも「画質や音質に関しては主観的にほぼ同等」と書かれています。⚠ 同じ土俵ではありません(1024×1792・4ステップ・RTX 4070)し、あちらも「固定10%スパースとの品質比較は測定していない」と断っていますが、0.3より下を試す余地があることは確かです。そこで測りました。
まずMVのサイズで予算を振ると、速さはこうなります。
予算 | 所要 | 比 |
|---|---|---|
1.0(密) | 82.3秒 | 1.00倍 |
0.3(いまの本番) | 60.3秒 | 1.36倍 |
0.2 | 57.7秒 | 1.43倍 |
0.1 | 52.3秒 | 1.57倍 |
0.05 | 50.3秒 | 1.63倍 |
ここで天井が見えます。比 = 1 / ((1−a) + a×予算)(aはアテンションが占める割合)に当てはめるとa ≈ 0.41で4点とも合い、予算を0にしてアテンションを完全に消しても1.69倍という計算になります。予算0.05は既にその96%。このサイズで、アテンションに残っているものはもうほとんどありません。
(記事の前半で「理論上限3.33倍」と書いたのはN→∞でアテンションが時間の100%を占めたときの話です。いまのサイズでの天井は1.69倍。別のものなので、混同しないでください。)
それでも0.3に留めた理由
下げれば速い。では下げるか——という判断のために、品質も測りました。
832×480で、8要素を名指しした札(前述)で予算を下げていくと:
予算 | 8要素 | 顔 |
|---|---|---|
0.3 | 8/8 | ✓ |
0.1 | 8/8 | ✓ |
0.05 | 8/8 | 2本とも崩れる(1本は目と口が溶けた) |
ここがこの日いちばんの発見でした。予算0.05でも、名指しした8要素は全部残ったのです。私が用意した物差しは合格を出す。**それなのに顔が壊れていた。**要素だけ数えていたら「0.05でも安全」と報告していました。
そしてこれは、この記事の主張そのものと辻褄が合っています。札には「A young woman in a bright red knit sweater」としか書いておらず、顔は名指ししていません。名指しした物は全部残り、名指ししなかった顔が先に壊れた。
では本番の条件ではどうか。MVはref2vaで参照画像に顔を錨で留めているので、話が違うはずです。同じシードで予算だけ変えて、ArcFace(実写48枚の重心との一致・0.28が同一人物の線)で測りました。
シード | 密 | 予算0.3 | 予算0.1 |
|---|---|---|---|
12000 | 0.357 | 0.337 | 0.360 |
12001 | 0.166 | 0.270 | 0.376 |
悪化は見えませんでした。⚠ ただしシードによる振れ(0.166~0.376)のほうが予算の効果より大きく、2組では「同等」とは言えません。言えるのは「この本数では悪化が見えなかった」までです。
それでも0.3のままにしました。理由は3つあります。
得が小さい。0.3→0.1で買えるのはMV1区間あたり6~12秒。上で見たとおり、このサイズではアテンション自体が時間の4割しかないので、どう削っても伸びしろが乏しい
物差しが信用できない。8要素の残存数は、顔が壊れても合格を出すことが分かってしまった。ArcFaceのほうも2組では振れに埋もれる
顔はMVの主役。失敗したときの損が、得た秒数と釣り合わない
④ そもそもトークンを減らす 式が0.240N + 6.62e-4N²である以上、Nを半分にすれば時間は半分以下になります。低い解像度で作って拡大する形。ただしこれは高速化ではなく作り方の変更なので、質の判断が要ります。
⑤ 層ごとに配分を変える layer_video_budgetsはまだ触っていません。全層に同じ0.3を入れただけです。層ごとに感度が違うのは当たり前なので、ここは余地が残っています。
そして最後に、冒頭の投稿に戻ります。作者は詳細解説でもこう断っています。「固定10%や5%のSLAだけでも、このレベルで高速化できる可能性がある」。
うちが測ったのは、まさにその「固定のスパース率だけ」の側でした。別のGPUで、別のサイズで、その但し書きが正しかったことを確かめたことになります。そして測ってみたら、アテンションは、思ったほど大きな相手ではなかった。残りの6割のほうが、これからの本題です。
まだ伸びる余地はある、ということですね。楽しみです。
※この記事は筆者との対話をベースにClaude Codeが執筆。筆者が原稿整理・追記をしたものです。作例・ログ・再現手順は https://github.com/matsuo-koya/minimax-h3-notes に置いてあります。