



生成AIグラビアをグラビアカメラマンが作るとどうなる? 連載記事一覧
MiniMax H3高速化の基本4つ
8月に引き続き9月に入ってもMiniMax H3の勢いは衰えず。と言うより他に目立ったものが出てないので、必然的にそうなってる感じだ。このような事情もあり、今回はMiniMax H3での大技小技をいくつかご紹介してみたい。
まず基本の生成速度向上。高速化モデルやLoRAなどを使わないと20 stepsは必要となり、これだけでも結構時間がかかる。生成速度を上げるにはstep数を落とすのが一番効果的だ。ただ、=多少工程を端折ることになり、映像や音に影響が出る。つまりどこまで許容できるか?によって高速化の内容も変わってしまう。
まず筆者が日頃使ってるパターンだと、以下三種の神器ならず四種の神器となる。
minimax_h3_fused_refdelta_r1024_turbo8_mystic07_int8_convrot.safetensors
Model Attention Backend → Model Sparse Attention
1はfl2va/ref2vaにも対応し4 stepsで作動する。この手のモデルはいろいろ試したが、4 stepsだとこれが一番調子いい(と思う)。次に安定しているのは、FastVideo-FastH3-8-Step-V2だろうか。名前の通り8 stepsになるものの結構行ける。
実は動画生成時、意外と時間かかってるのがVAE Decode。数十秒使ってるので、ここを高速化すると目に見えて速くなる。通常だとVAEはfp16を使うが、ここをint8にするだけでかなりの高速化が可能。ダウンロード後、単にLoad VAEで選択するだけなので手間もかからない。
次のそのVAE Decode本体の高速化。ただこれに関しては最近ComfyUIのUpdateの中にVAE Decodeの高速化が含まれており少しの差なのでカスタムノードを入れてまで対応する必要はないかも知れない。
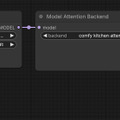
そして最後はModel Attention Backend → Model Sparse Attention。ComfyUI標準のノードなので特に何かをする必要は無い。使い方もMODELの後ろへ入れるだけなので簡単。各項目の設定は以下のworkflowを参考にしてほしい。
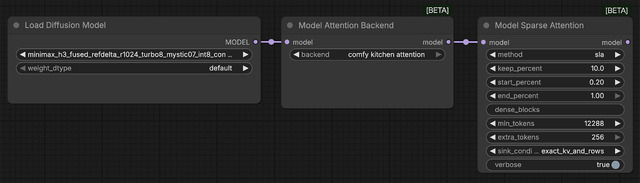
まずModel Attention Backendは、comfy kitchen attentionを選ぶ。次にModel Sparse Attentionはsol-attn/sla/vsaの三択。筆者の環境ではslaが若干速かった。あとは順に10.0/0.20/1.00/無し/1288/256/exact_kv_and_rows/true。
ここでのポイントは0.20/1.00。これは%、つまりこのノードが効く範囲を設定している。0~20%までは適応外となり遅いままだ。これを0.00/1.00にすれば全てに効くため結構速くなるものの、その分画像も音も荒れる。速さを取るか?クオリティを取るか?はお好みで。
以上でそれなりに速く生成できるようになったのではないだろうか? 以降は大技小技編となる。
VOSR2を使ったFace Refiner
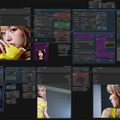
MiniMax H3用のFace Refinerはいくつか出ているが、筆者的にお気に入りはこれ。仕掛け的には元動画の顔周辺だけをクロップ(左上)、それを元にMiniMax H3を使ってdenoise 0.4で再レンダリング(右上)、次にVOSR2でもう一回refine(ノード自体はUpscalerだが倍率は1.0のまま/左下)、元動画へ戻して完成となる(右下)。
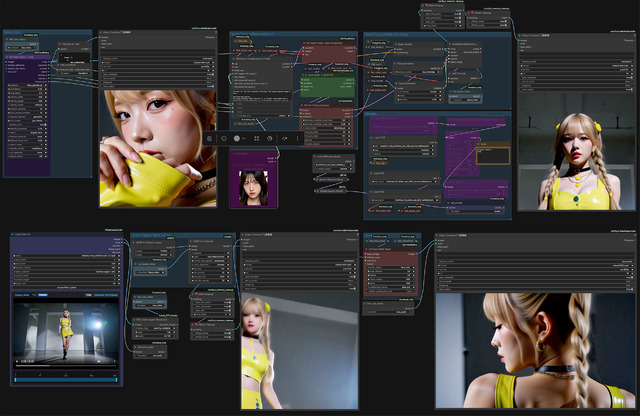
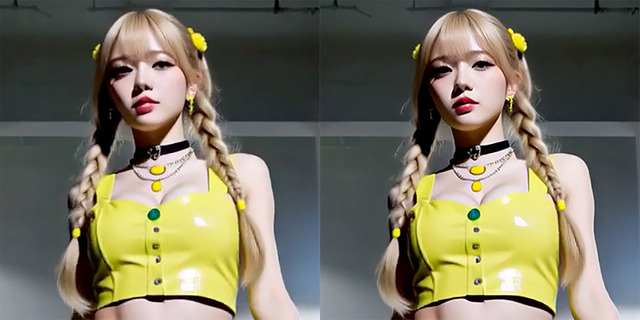
引きの構図は解像度上、どうしても顔が崩れてしまうが、Face Refine後の結果はご覧の通り。かなり改善されている。
カスタムノードはこれなのだが他にも使っているのでないものはインストールしてほしい。またWorkflowはここ。動きがゆっくり用と速い用2種類ある。
ComfyUI MiniMax H3 Extender
MiniMax H3は最大15秒なのだがこれを拡張する方法の1つ。この手のカスタムノードはいろいろ見たものの、中でもComfyUI MiniMax H3 Extenderは扱いやすいタイプだ。
使い方はWorkflowを見れば一目瞭然。勝手に尺が伸びる訳でなく、15秒以内のクリップを必要分だけ作りそれを繋げて一つにする。
各クリップのつなぎ方は2種類あり、1つはMotion Context使用、もう一つは普通に連結。前者は続く動画へ継ぎ目なく繋がるのが特徴。
作りたい動画にもよるだろうが、ドラマや映画などは、よく見ていると10秒前後で俳優や場所などは同じでもアングルなどを変えている。これでよければ後者。前者は長回しでずっと繋がってる映像となる。モードは上にあるボタンの[MOTION ON/OFF]で設定。
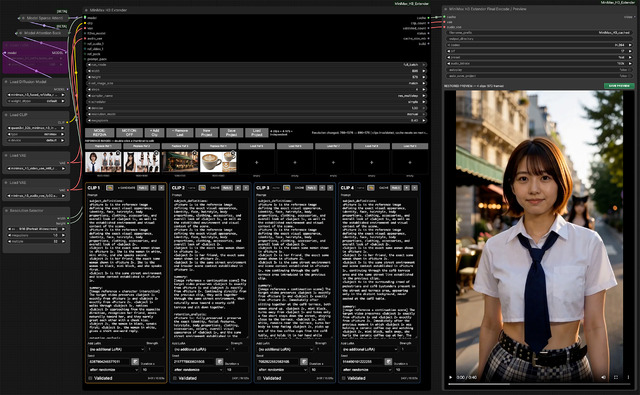
またクリップが分かれているので例えばクリップ2だけSEEDガチャ……もできるのだが、MOTION ON(Motion Context)だとこれはNG。なぜかというと後の動画に繋がってるので、前の動画が変わってしまうと辻褄が合わなくなるからだ。最後のクリップのみ、後ろがないのでSEEDガチャ可能となる。
ref2vaの参照画像を最大15へ拡張
MiniMax H3のref2vaの公式スペックは以下の通り。
参照ファイルの上限(公式)
参照画像: 最大9枚
参照動画: 最大3クリップ
参照音声: 最大3ファイル
合計: 最大12ファイル
音声単独送信は不可(画像/動画のいずれかと必ず併用)
参照動画・参照音声はそれぞれ2~15秒/クリップ、合計15秒まで
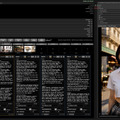
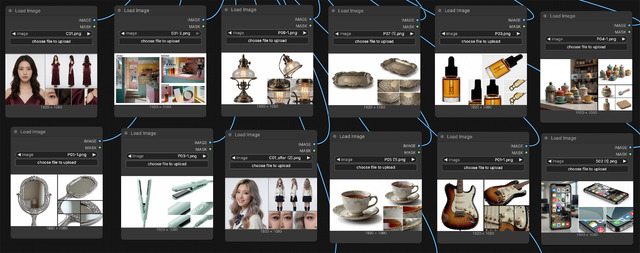
つまり参照画像は最大9枚まで。これを(勝手に)拡張したのが筆者自作のminimax_h3_ref_extend。参照画像15枚まで入力できる。以下Workflowだが、構図などはともかくとして、生成結果にギター(10枚目)とスマホ(11枚目)があるので9枚は超えている。
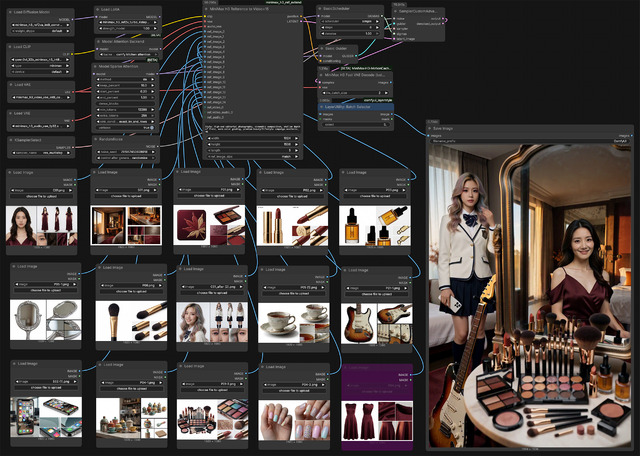
これは動画のキーフレームを作る時、登場人物や(キーとなる)小物が多かったりすると9枚では足らなくなるため自作。公式スペックは上記の通りだがやってみたら動いてるので(笑)、カスタムノードとして公開した。とは言え、スペック無視の拡張なので、クラッシュはしないものの、効果のほどは何とも。使用は自己責任でお願いしたい。
似た動画2つを繋げるMiniMax H3 Bridge
これはMotion Context(続きを作る仕掛け)の応用なのだが、動画Aと動画Bの間を繋ぐ5秒を作る。仕掛け的に全く違う動画同士は厳しいが、グラビアイメージ的な衣装と場所が同じのアングル違い的なものはうまく繋がる。Workflowはここ。
今回締めのグラビア
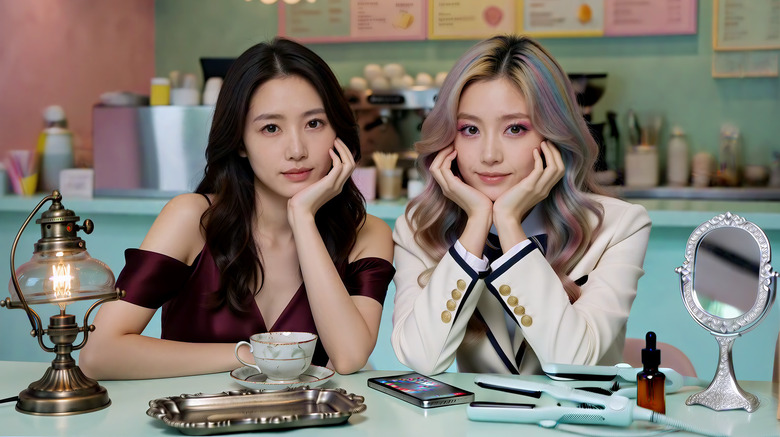
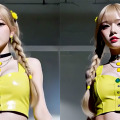
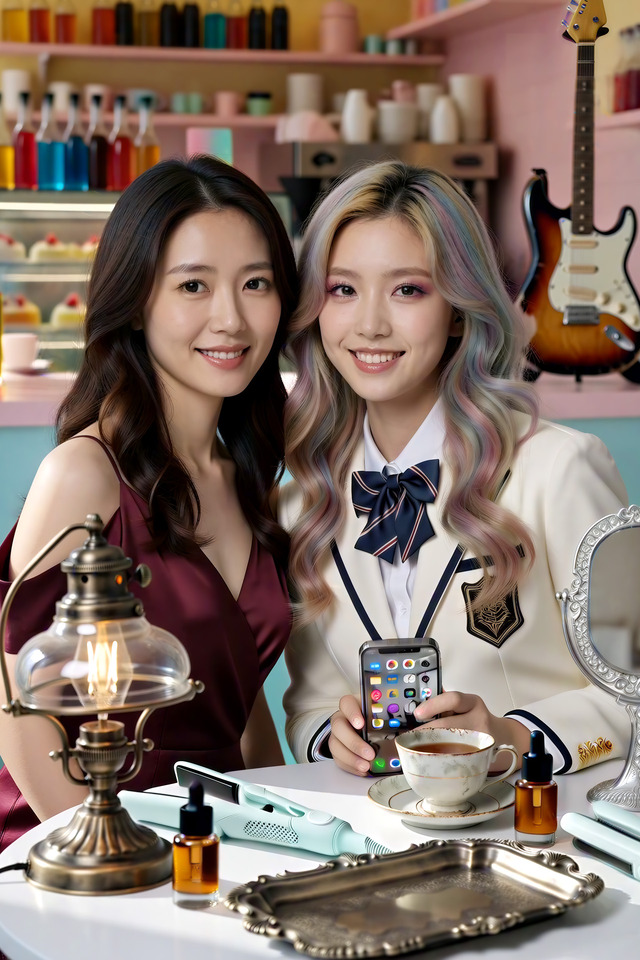
今回締めのグラビアは、minimax_h3_ref_extendを使い、参照画像12枚で構成(扉とグラビアで店内写真だけ入れ替え)、動画ではなく画像として出力した。扉と共に長辺1536で生成、VOSR2でx2 Upscaleした後、1920pxへ縮小。掲載サイズに合わせている。結果はいかに!?(笑)。
どうやらQwen-Image 2.1がそろそろオープンで公開されるらしく、またXは賑やかになるかも!? ComfyUIは既に対応済みなのでモデルが公開されれば即使えるはずだ。