



生成AIグラビアをグラビアカメラマンが作るとどうなる? 連載記事一覧
2026年秋は生成AI画像の当たり年?
この秋、リリースされた主なオープンウェイトは以下の通り。前回既にiris-3bは紹介済みだが、その後、FLUX 3 Image KleinとMOSS-Image、2つが登場した。
Qwen-Image-2.1 9月20日
Qwen Research License 商用利用:原則不可(研究・評価目的限定、商用は別途個別契約が必要)iris-3b 10月8日(arXiv論文発表)
Apache License 2.0 商用利用:可能(制限なし、自由な利用・改変・再配布が可能)FLUX 3 Image Klein 10月15日
FLUX Kommunity License v1.0 商用利用: 条件付きで可能(年間総売上500万米ドル未満の個人/企業は生成物の商用利用可。モデルの再配布や商用目的のファインチューニングは不可)MOSS-Image 10月16日
Apache License 2.0 商用利用:可能(制限なし、自由な利用・改変・再配布が可能)
Qwen-Image-2.1に関しては、ライセンスの関係で記事掲載OKかを面識のある担当者に問い合わせてるものの、(やり取り自体はあったのだが)明確な返答なし。
FLUX 3 Image Kleinも相変わらずなライセンスで且つKleinはKlein。ComfyUIは対応しているのだが、生成される画像のクオリティ的にFLUX.2 [klein] の時と変わらずイマイチ。FLUX 3 Devを待ちたいところ。
そんな中Apache License 2.0で何にでも使え、高い性能/クオリティを持ったMOSS-Imageが登場した。もちろんComfyUIやai-toolkitもday-0対応済み。今回はこれをメインにご紹介したい。
MOSS-Image
主な特徴は以下の通り。
名称: MOSS-Image (MOSS-Image-Base / MOSS-Image-SFT)
開発: OpenMOSS (MOSI.AI / MOSI Intelligence)
モデル規模: 5B
テキストエンコーダ: Qwen3.5-9B
入力形式: 自然言語 / タグ列 / Layout JSON
プロンプト長: 最大 4Kトークン
ライセンス: Apache 2.0
OpenMOSSは初耳だが、「テキスト・画像・音声・動画を自由に扱える次世代の高度なAIモデルを開発し、誰もが使えるように世界へ無償公開している研究組織」ということらしい。
また凄まじいのが学習に使った画像枚数。
入力: 55.3億
除去された分: 23.0億(重複除去+AI画像除去)
実使用画像数: 32.3億
なんと32.3億枚から学習したというのだ。しかも生成AI画像を除外、リアルな画像のみが対象。そんな枚数どこから用意したの? という話は別問題として(笑)、生成される画像を見れば納得感がある。
加えてフィルタリングは全く行っていない。この辺りの話は、技術レポート、arXiv: 2610.23374(2026年10月19日公開、35ページ)に書かれており、フィルタリングなしの方が精度が上がるそうだ。(おそらくフィルタリングしまくって)体が崩れることが多いFLUX 3 Image Kleinとは対照的だ。
MOSS-Image-Base / MOSS-Image-SFT
今回公開されたのはMOSS-Image-BaseとMOSS-Image-SFTの2種類。前者は生成用と言うより学習に使うベースとなる。後者はSFT(Supervised Fine-Tuning)モデルで生成はこちらを誓う方が調子いい(Baseで生成できないと言ってるわけではない)。
ComfyUIで使用するウェイトは
https://huggingface.co/Comfy-Org/MOSS-Image
ここにある。bf16とint8、baseとsftで合計4本登録されている。テキストエンコーダーはqwen3.5_9b(bf16/int7/w4a8)、VAEはflux2-vae(small版もある)。Workflowはテンプレートに標準で用意されているので簡単に試すことが可能。
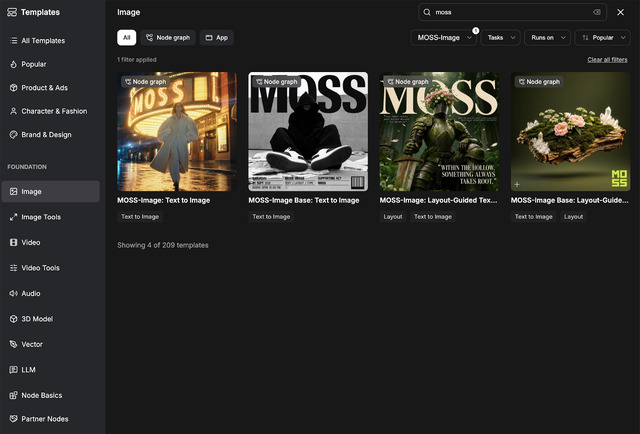
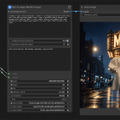
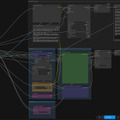
T2IのWorkflowを開くとSubgraphが使われており、詳細がよく分からないので、2つ目が内容となっている。
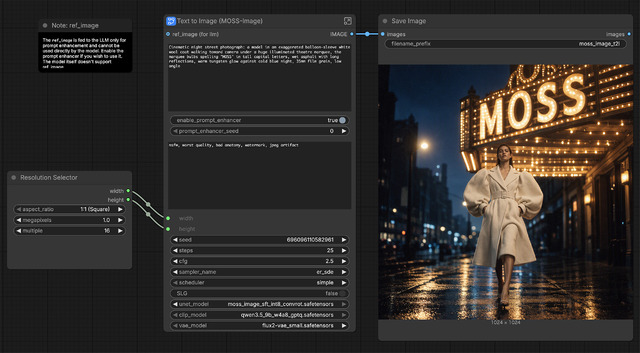
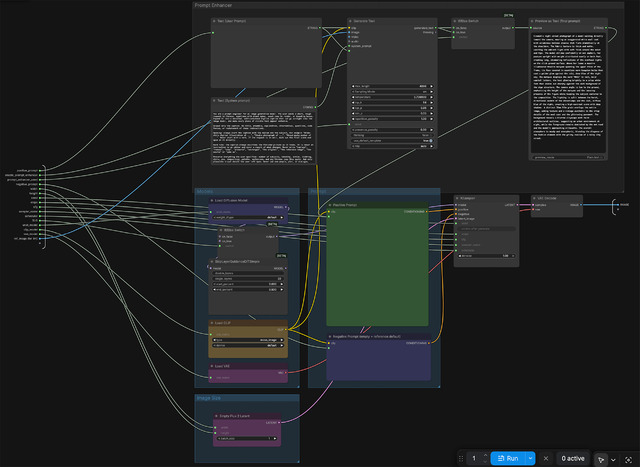
Subgraphの中身は上側がPrompt拡張(ON/OFF可能)。qwen3.5_9bがそのままLLMにも使われている。下側が実際のWorkflowでLoad Diffusion Model、Load CLIP、Load VAE、Prompt(Negativeも含む)、KSampler、VAE Decode…と、一般的なT2Iで難しい部分はない。
ただし、MODELとKSamplerの間にSkipLayerGuidanceDiTSimpleという見慣れないノードがあり、フロント側のUIからSFTでON/OFF出来るようになっている。
以下は、baseとsftの違い。何時もの”a Japanese woman”。1MP, 25 steps, cfg 2.5, er_sde / simple。
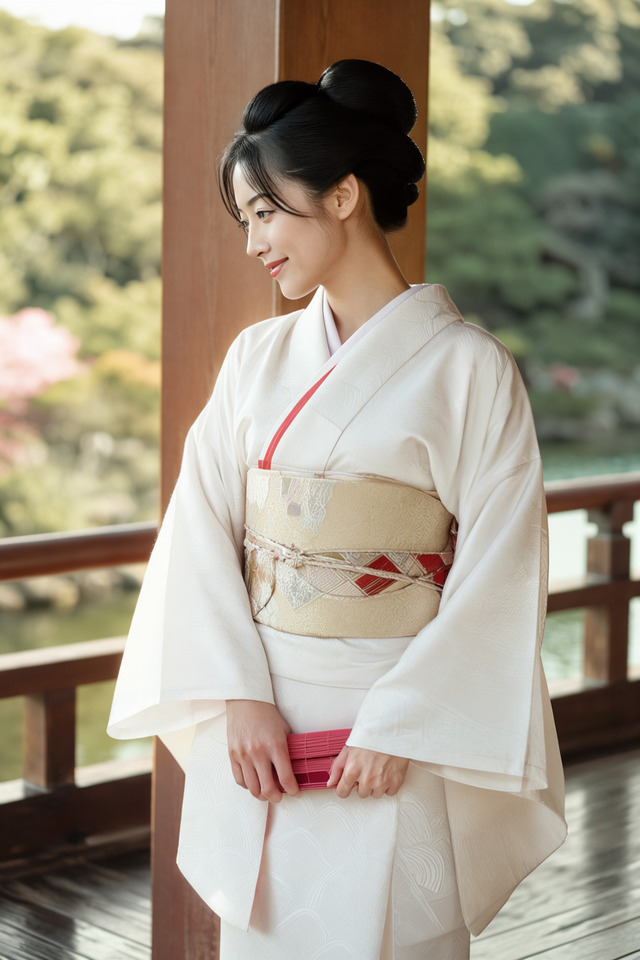 | 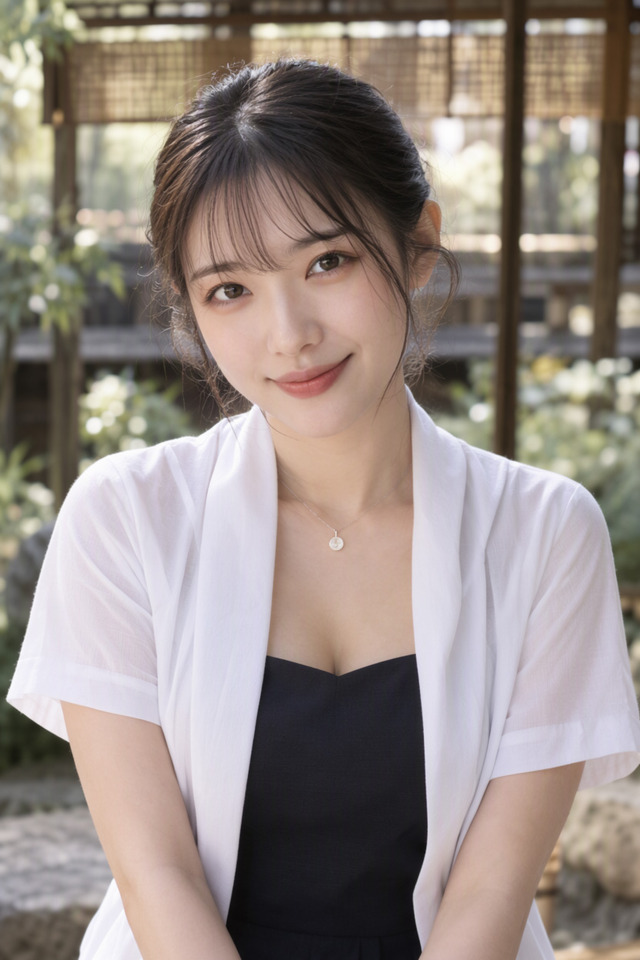 |
双方でガチャったところsftの方が構図や絵柄は安定している。その関係もあり以下の作例は全てsftを使用した。
 | 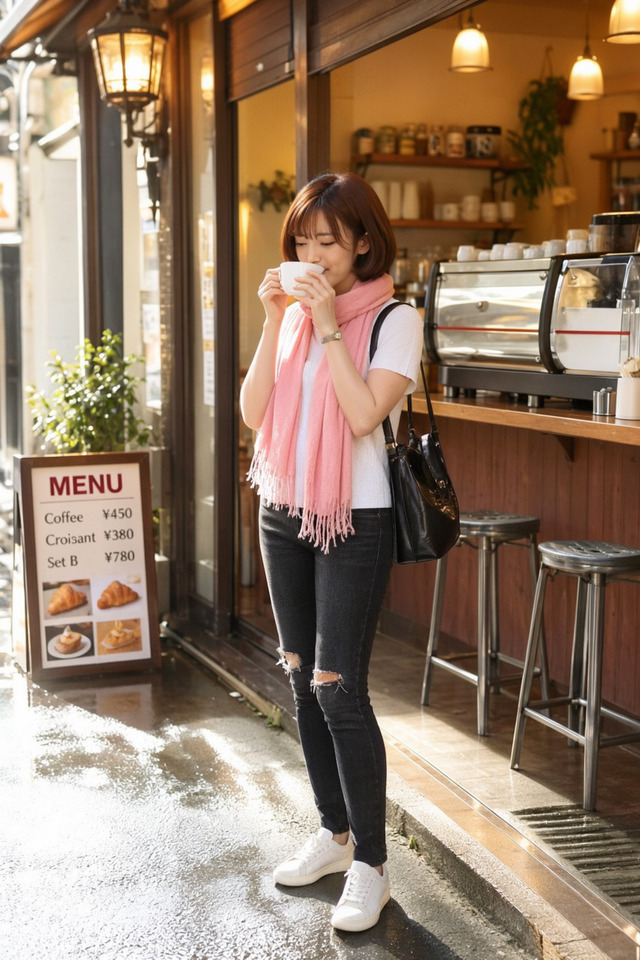 |
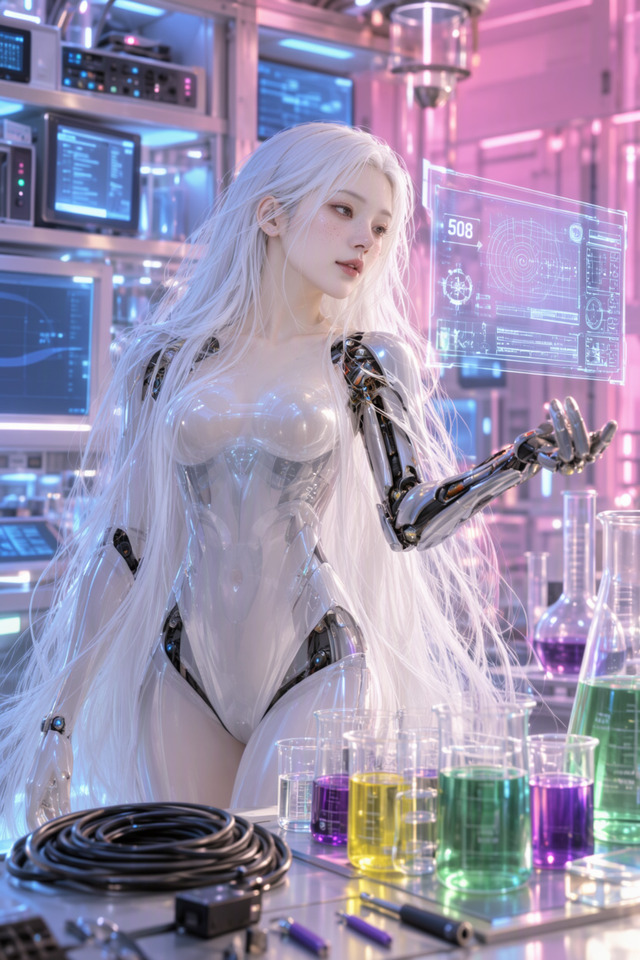 | 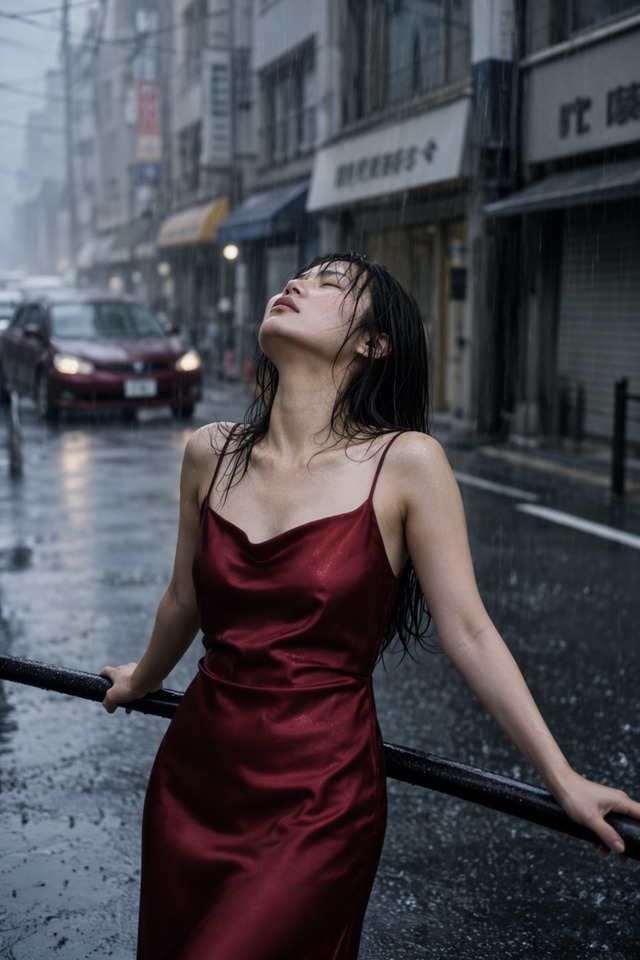 |
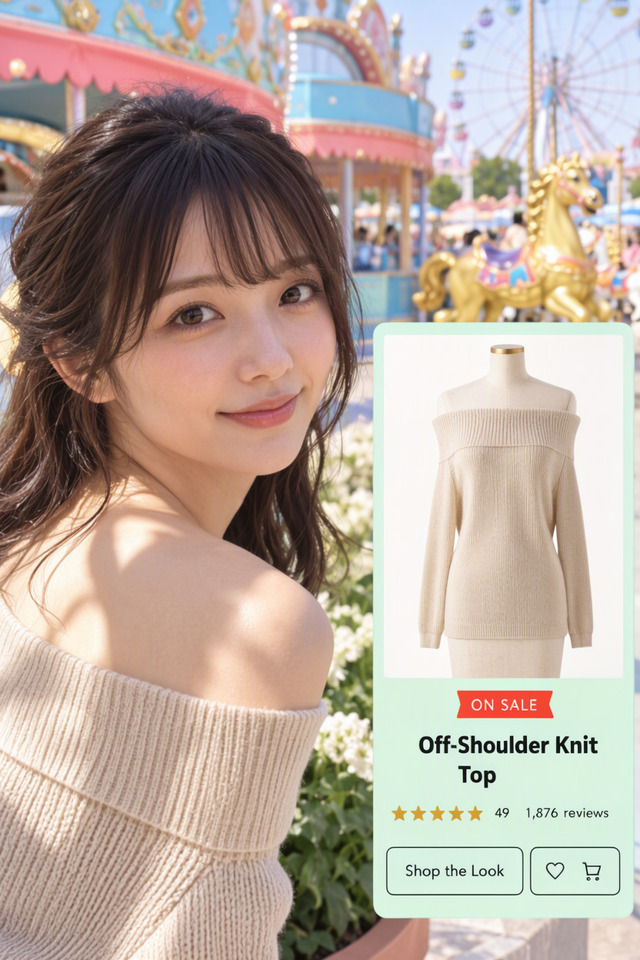 | 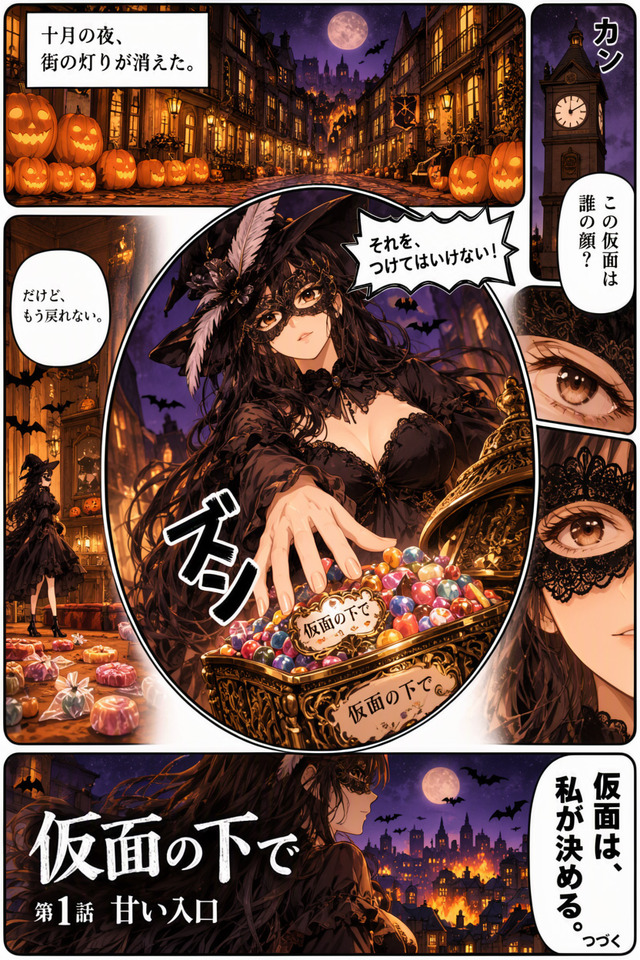 |
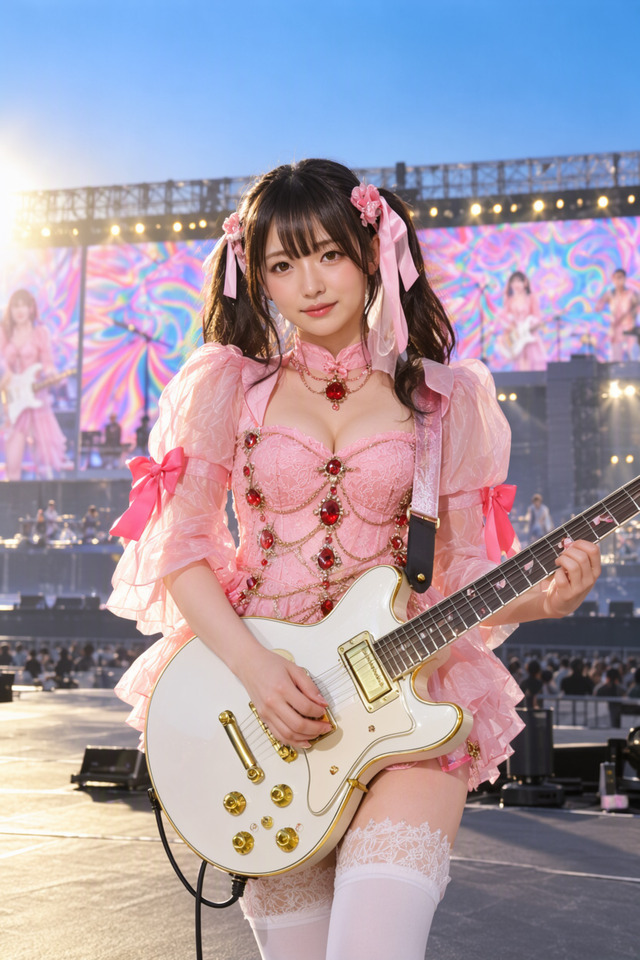
ご覧のようになかなかの画質。驚くべきは一番最後。これはjsonで指定するのだが、文字化けも無く、完全にレイアウトされた漫画が出来ている。
次にsft用8 steps LoRAがあるので、ON/OFF(25 steps)の違いだ。重み自体は2つあるが、lora_latest.safetensorsの方を0.7で使用する。CFGは1.0-2.5。
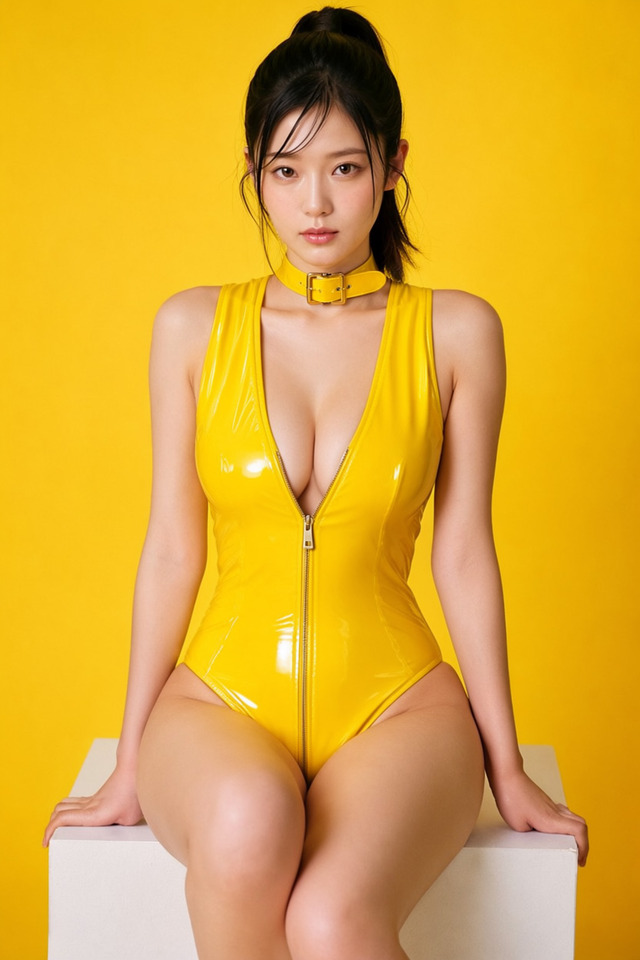 | 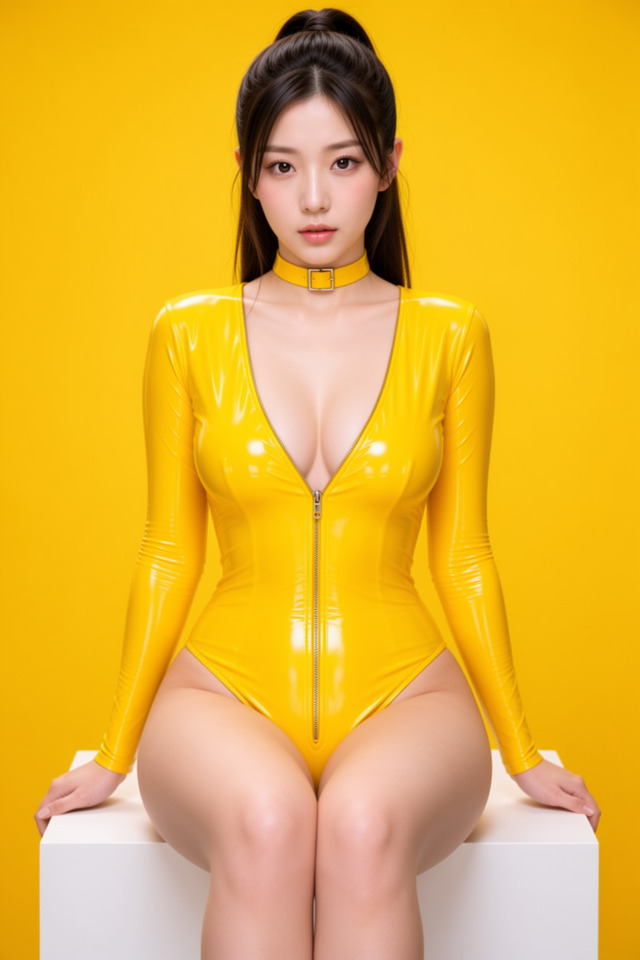 |
LoRAなしの方は立体感がありなかなかいい。これを見てしまうと8 stepsはイマイチな感じだが、生成速度が速いので出力したい内容で切り替える感じだろうか。扉とグラビアは8 steps LoRAを使っているのだが、比較せずこれだけ見ている分には気にならない。
今回締めのグラビア
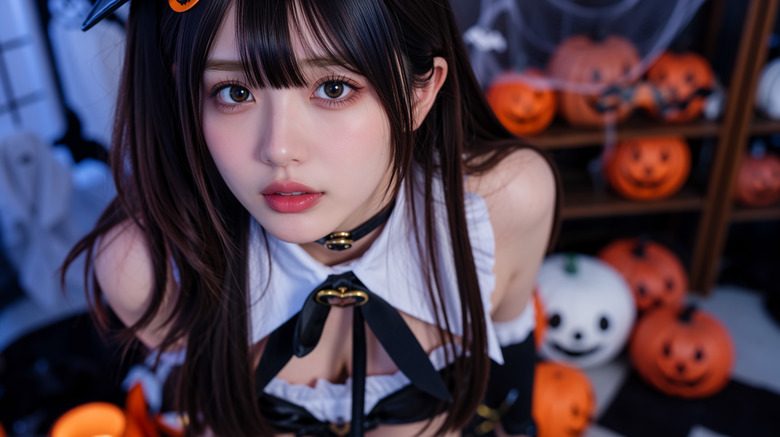
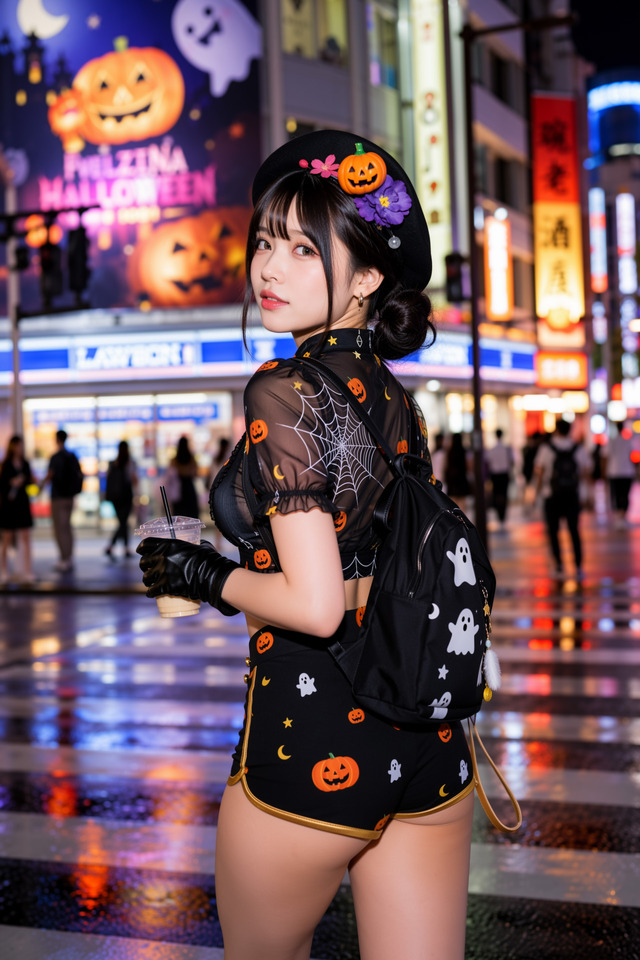
今回締めのグラビアは、扉、グラビア共にMOSS-Image-SFT + 8 steps LoRA(0.7) + 肌LoRA(0.4)を使用。掲載解像度に合わせて長辺を1920pxで作っている。前回に引き続きお題はHalloween。これが終わると11月だ。
次回はMOSS-ImageのEdit機能やJSON形式によるレイアウトなど、単純な生成以外の部分をご紹介したい。お楽しみに!