



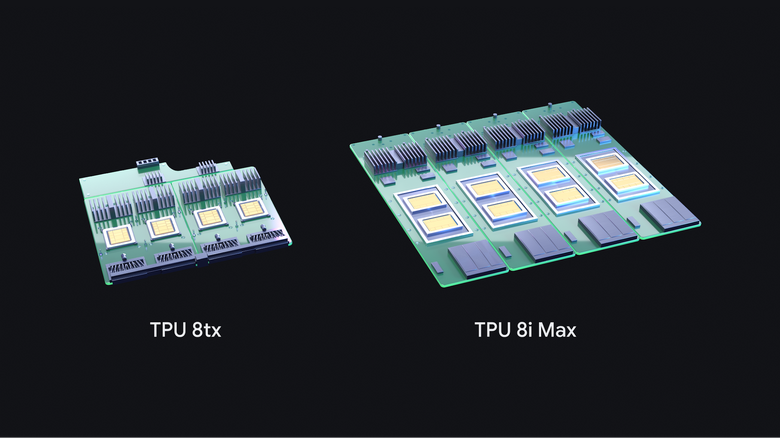
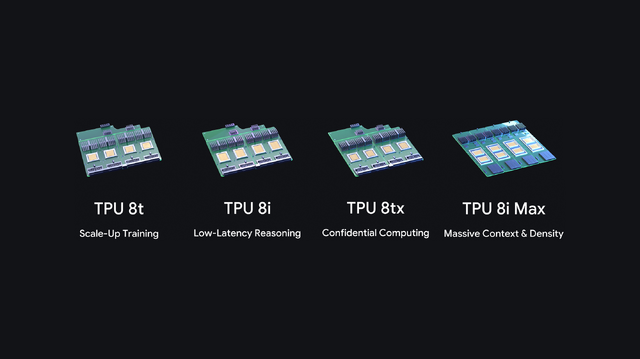
Google Cloudは11月9日(米国時間)、第8世代TPUに新しいシステムを2つ追加すると発表しました。機密データを扱う推論向けの「TPU 8tx」と、長いコンテキストを扱うAIエージェント向けの「TPU 8i Max」です。4月に発表した学習向けの「TPU 8t」、推論向けの「TPU 8i」に続くTPUです。なおいずれも提供開始時期や価格などは明らかにされていません。
TPU 8tx:使用中のデータを守る
データは保存中や通信中なら暗号化できますが、計算するときにはメモリ上で復号するため、これまでは計算中のデータは暗号化できていませんでした。今回のTPU 8txは、暗号化の仕組みをソフトウェアではなくチップ側に持たせることでこの問題に対処します。
チップ性能は4月に発表したTPU 8tと同じもので、FP4(4ビット浮動小数点)で12.6PFLOPSの演算性能と216GBの広帯域メモリを備えます。発表によると、1)ホストとTPUを結ぶPCIe接続の暗号化、2)このTPUとホストが正規のハードウェアとソフトウェアで動いているということの証明、3)メモリの中に外から読めない囲いを作る仕組み(エンクレーブ)を、ハードウェアで実現すると説明しました。独自のLLMや社内データを計算中も外から見えない状態で動かせるということです。
TPU 8i Max:エージェントを同時にたくさん動かすためのメモリ
100万トークン級のコンテキストを持つエージェントを並列に動かすと、計算速度よりもメモリの帯域がボトルネックになります。その場合、コンテキストを削るか、同時に動かすエージェントの数を減らすか、遅延を受け入れるかのどれかを選ぶしかありません。
TPU 8i Maxは、TPU 8iのチップ2つを1つのパッケージにまとめた構成です。広帯域メモリは384GBで、TPU 8i(288GB)より33%多くなります。メモリの読み書き速度は17.2TB/sでTPU 8iの2倍、オンチップSRAMは768MBでこちらも同2倍。演算性能もTPU 8iの2倍です。ただし、1つのエージェントがトークンを生成する速さは変わりません。増えた計算力とメモリは、同時に動かせるエージェントの数を増やすことに使われます。Googleはこれを「制限速度は変えずに車線を増やす」とたとえています。今のラックと同じ設置面積に2倍のシリコンを載せられるため、床面積あたり・電力あたりの計算能力も上がります。
ソフトウェアも同時に発表
TPUの分散実行基盤「Cloud Pathways」をコンテナ管理サービスのGKE(Google Kubernetes Engine)で一般提供し、光回線スイッチでTPUの割り当てを組み替える「GKE動的スライシング」も一般提供を始めました。動的スライシングはジョブの起動時間を最大5分の1に縮め、障害からの復旧を最大4.5倍速くするとしています。待機中のエージェントのKVキャッシュをチップの外へ退避させる「TPU Sync」もオープンソースで公開しました。KVキャッシュの転送遅延と、最初のトークンが出るまでの時間(TTFT)を90%以上減らすとしています。