



この1週間の気になる生成AI技術・研究をいくつかピックアップして解説する今回の「生成AIウィークリー」(第166回)は、スマホでも高速で動くオープンウェイトのAIモデル群「LFM3」や、数百ページの文書を一括解析できるローカルOCRモデル「Unlimited OCR 2」を取り上げます。
また、複数話者の文字起こしなどができるNVIDIA開発の音声AI「Nemotron 3.5 Transcribe」や、GPT-6.1 Terraと同等のコーディング性能を持つAIモデル「Mistral Large 4」をご紹介します。
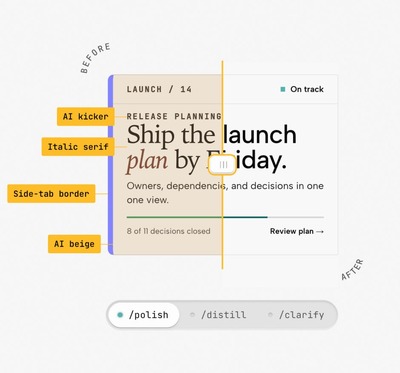
そして、生成AIウィークリーの中でも特に興味深いAI技術や研究にスポットライトを当てる「生成AIクローズアップ」では、Claude CodeやCursorなどのコーディングAIにWebページやアプリなどを作らせると、AIっぽい(AIスロップ)UIになる現象を排除するスキル3つを別の単体記事で取り上げています。
NVIDIAが音声AI「Nemotron 3.5 Transcribe」発表。複数話者の文字起こしや双方向翻訳などに対応し商用利用も可能
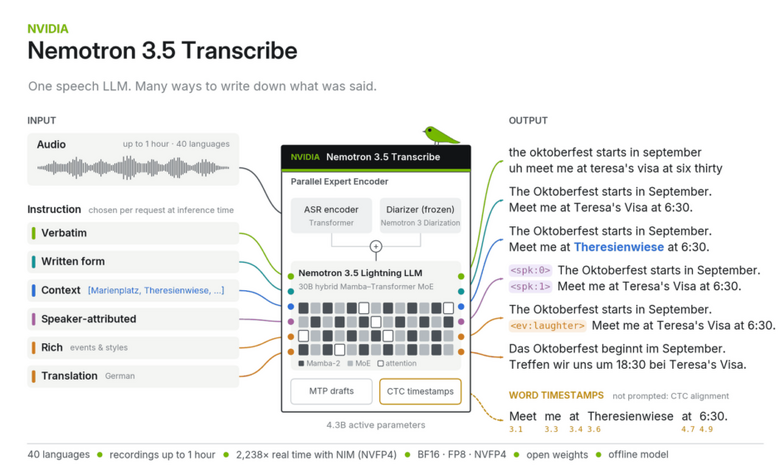
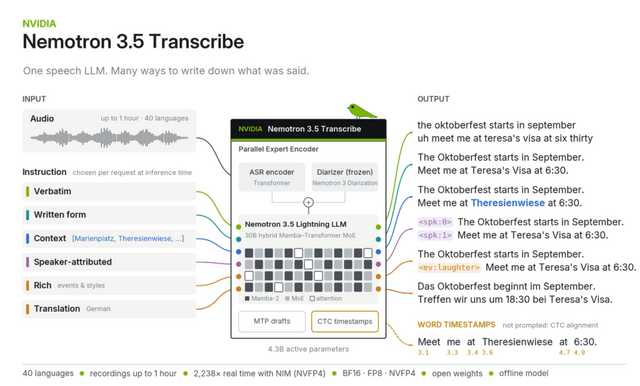
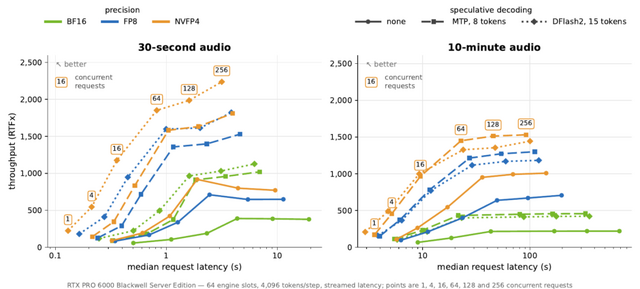
NVIDIAは、40言語に対応するオープンウェイトの音声認識AIモデル「NVIDIA-Nemotron-3.5-Transcribe-30B-A4B」を公開しました。文字起こし、音声翻訳、言語識別、音声に関する質問応答などに対応します。
総パラメータ数は34B(340億)で、推論時は約4.3B(43億)パラメータで稼働します。重みデータはBF16のほか、量子化版のFP8やNVFP4形式でも提供されています。
本モデルは、言語モデルの「Nemotron-3.5 Lightning」に音声認識と話者識別のエンコーダを組み合わせたMoE構造を採用しています。最大1時間の録音データと65,536トークンのコンテキスト長に対応し、商用・非商用を問わずに利用できます。
また、日本語も実用レベルでサポートされており、英語との双方向翻訳、複数話者認識に対応しています。
NVIDIA-Nemotron-3.5-Transcribe-30B-A4B」
NVIDIA
Paper | Blog | Hugging Face
一部のコーディング指標でGPT-6.1 Terraと同点のAIモデル「Mistral Large 4」がオープンウェイト公開。1兆パラメータの大型
フランスのAI企業「Mistral AI」は、最新のマルチモーダルAIモデル「Mistral Large 4」(通称:Le Chonk)のオープンウェイトを公開しました。
総パラメータ数は約1兆(アクティブパラメータ520億のMoE)で、コンテキスト長は最大100万トークンです。ライセンス上、利用・改変・追加学習・商用利用が可能ですが、Model as a Serviceを提供する事業者は商用利用の前に別途ライセンスを取得する必要があります。
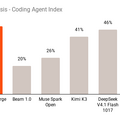
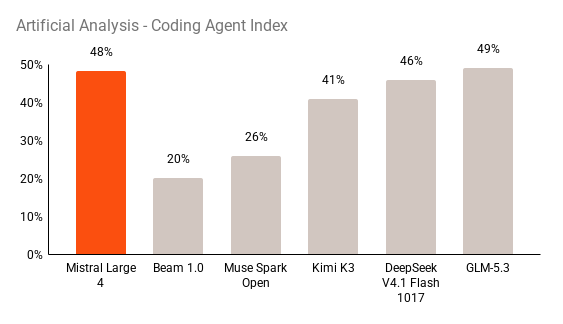
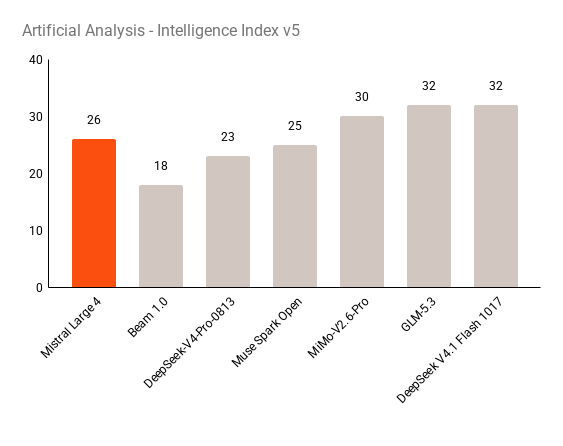
Artificial Analysisのコーディングエージェント指標では48%を記録しました。Mistralは、オープンモデル首位のGLM-5.3と事実上同点で、タスクあたりのトークン消費は平均47%少ないとしています。また同指標で、Mistral Vibe上のMistral Large 4のスコアは、Codex上のGPT-6.1 Terraと同じでした。
Mistral Large 4
Mistral AI
Blog | Hugging Face
スマホでも高速で動くAIモデル群「LFM3」がオープンウェイト公開。テキスト・視覚・音声・意思決定など6モデル
Liquid AIは、スマホやPCの端末上で直接動く、オープンウェイトの小型AIモデル群「LFM3」を公開しました。
テキストモデルは4ビット精度で約1GBのメモリに収まる軽量設計ながら、新しいアーキテクチャと学習手法により、エージェント系タスクなどでは数倍の規模のモデルに匹敵する性能を発揮します。
ラインアップは、ツール操作や自律作業に強いテキスト用の「LFM3-1.7B」、動画理解や空間把握に対応した視覚用の「LFM3-VL-2B」、18言語の音声認識・合成・翻訳に対応し、低遅延の音声対話もできる音声用の「LFM3-Audio-2B」、映像と音声を同時に理解してツールを動かす統合型の「LFM3-Omni-2B」です。
他にも、判断だけを数ミリ秒で返す意思決定モデルの「d1-2B」と「d1-Omni-2B」が揃っています。
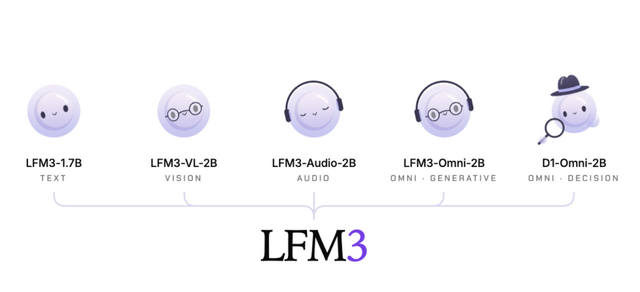
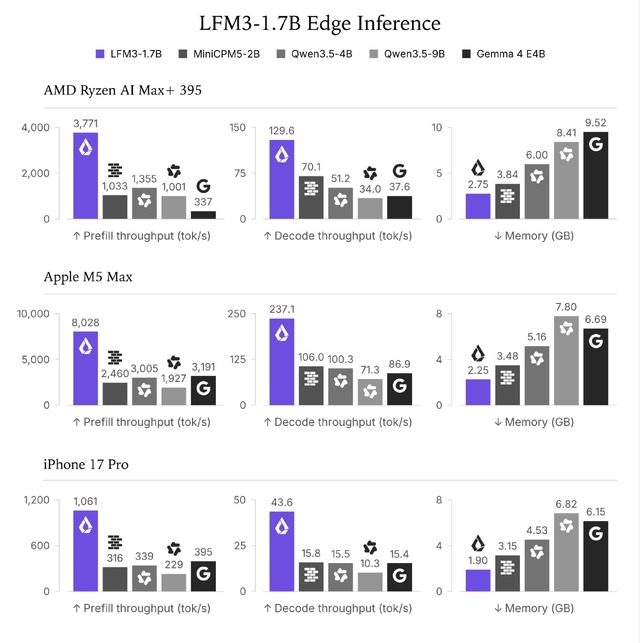
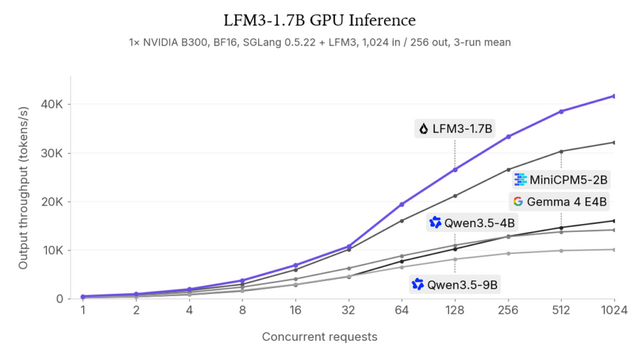
LFM3
Liquid AI
Blog | Hugging Face
数百ページの文書を一括解析できるOCRモデル「Unlimited OCR 2」、Baiduがオープンウェイトで公開
BaiduのERNIEチームは、数百ページに及ぶ長文ドキュメントを一括で解析できるモデル「Unlimited OCR 2」をMITライセンスで発表しました。
前身の「Unlimited OCR」では、デコードのたびに文書内の全ページの視覚トークンを参照し続ける必要がありました。そのため、ページ数が増えるほど1ステップあたりの計算コストが膨らみ、数百ページ規模の文書を処理するのは困難でした。
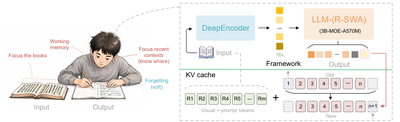
この課題を解決するため、研究チームは人間が本を書き写す際の現在のページに集中し、必要な時だけ前のページを振り返るという動作をモデルに取り入れ、新しい注意機構「SR-SWA」を開発しました。これにより、一度に処理する画像データの量を一定の上限内に抑えることに成功しました。
さらに、文書をチャンクに分けて順に処理し、不要なデータをメモリから解放するデコード手法と組み合わせることで、何百ページもの文書でもメモリ使用量と1ステップあたりの処理速度をほぼ一定に保てます。
100ページ規模の文書では、Unlimited OCR 2は標準的なFull Attention(全トークンを参照する方式)と前身のR-SWAに比べ、1ステップあたりそれぞれ7.0倍、5.6倍の高速化を達成しました。さらに、最大30ページの文書を扱うベンチマーク「MPDocBench」と、同社の最大300ページの文書解析ベンチマーク「MarathonDocBench」の両方で最先端(SOTA)を達成しました。
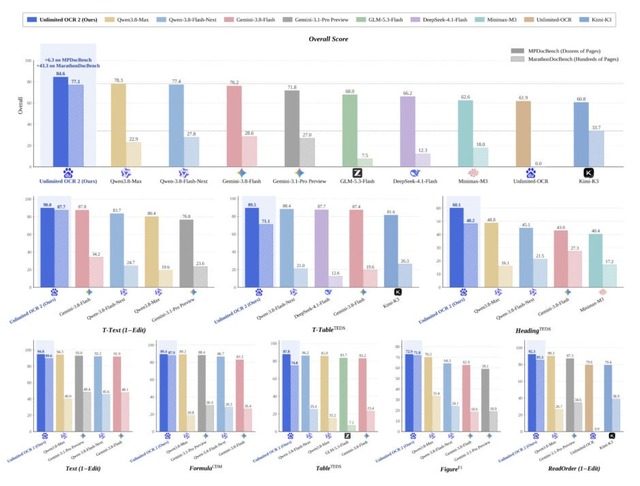
Unlimited OCR 2
Baidu
Paper | GitHub | Hugging Face