



生成AI技術を使って、古い写真を高精細にすることはもはや簡単です。NVIDIAのDLSS5やソニーのQSSRなどゲームでもできています。じゃあ、歌声は? 音楽は? ひょっとして、今日、できたかもしれません。1世紀前のボーカル曲の音質を著しく向上できたとしたら。
ロバート・ジョンソンの「Cross Road Blues」を聴いていて、ふと思いました。

この声が、いまのスタジオで録られていたら、どう聞こえたのだろう。
クリームでエリック・クラプトンが弾くカバーの方が知られているとは思いますが、原曲は1936年11月、テキサス州サンアントニオのホテルの一室で録音されました。SP盤の音は、高いほうが4~5kHzあたりでなだらかに消えていき、その先には針の音が残っています。歌もギターも、薄いベールの向こうから聞こえてきます。
十字路で悪魔に魂を売り渡さなければ、同時代のブルースマンであるマディー・ウォーターズくらいまで生きて、高品質な歌声を残していたかもしれません。

筆者はこの夏、VoxScoreという音楽の実験場で、歌声の音質を上げる道具をいくつも作ってきました。その延長で、古い録音の歌声を「作り直す」道具を作りました。名前は「Vocal Restore」です。
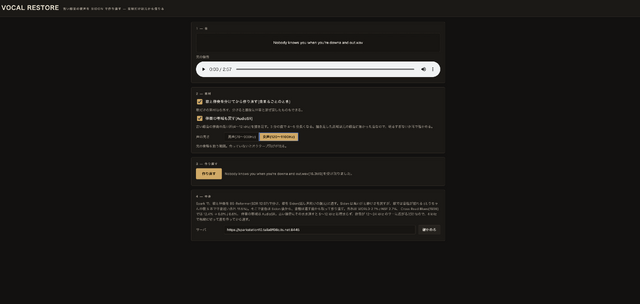
▲Vocal Restoreの画面のスクリーンショット
これまでの道具は、雑音や残響を「取り除く」ことはできても、録音されなかった音を「作り直す」ことはできませんでした。そこへ、東京大学の猿渡・齋藤研究室が公開した音声復元モデル「Sidon」が加わって、一段上のことができるようになりました。
このSidonを見つけたのは、ポッドキャストbackspace.fmを一緒にやっているシリコンバレー在住のソフトウェアエンジニアのドリキン。彼はいま、AIコーディングで日米をまたいでポッドキャストを収録するための独自ソフトを開発しているのですが、その過程で、自分の録音の品質を格段に上げる方法を考えつきました。そこで、エージェントとして使っているGLMが見つけてきたのが、このSidonだったのです。
筆者はAston Originという高品質のコンデンサーマイクを使い、彼はAirPodsの内蔵マイクというバランスの悪い組み合わせで収録したセッションでも、Bluetoothマイクのコーデックでどうしようもない16kHzの音質を向上させるという無謀な要求をAIに突きつけた結果、この研究を発見したというわけです。
昨年発表されたSidonの存在を筆者は迂闊にも見逃していました。知っていればすぐにでも取り入れたでしょうに。妻の昔の音源をできる限り復元しようとしている自分が一番必要としている技術だからです。
ただし、Sidonは話し声のためのモデルなので、歌にそのまま使うと音高が崩れます。そこで、音色はSidonから、音高(F0)は元の録音から借りて組み立て直す、という方法に行き着きました。
これまでは引き算だった
Sidon以前に何をしてきたか。どれも「歌声をきれいにする」ための道具ですが、すべて引き算でした。
学習素材のフロアノイズ
声を別の声に変えるRVCというAIボイチェンのモデルをある歌声を学習させていたときのことです。変換した声に、元の声には無いサーッというフロアノイズが乗りました。
最初は「音量の正規化で持ち上げすぎているのでは」と疑いました。ところが、変換のコードを読むと、音量は下げることはあっても上げることはありません。測ってみると、原因は学習素材そのものでした。音源分離で取り出した歌の素材は、静かなところの雑音が本編から5~16dBしか下がっていなかったのです。8本中きれいなのは1本だけでした。
モデルは、素材が持っていた雑音まで含めて「その人の声」として覚えます。汚い素材から学べば、汚い声になる。当たり前のことですが、測定するまでは気づきませんでした。
Vocal Clean:コーラスと残響を外す
次に作ったのが「Vocal Clean」です。Sunoで作った曲のボーカルのステム(分離した単独トラック)には、コーラスや残響が残っています。これが歌い方の分析を狂わせますし、トラックダウンするエンジニアにとって邪魔になります。
ある曲では、リードボーカルが歌っていない35.9秒を、分析器が「声がある」と誤認していました。コーラスと残響を、声として追っていたのです。
Sunoのステム分離はリードボーカルとバッキングボーカルを別トラックにしてくれる優れものなのですが、それでも失敗が多く出ます。さらに、著作権管理が異様に厳しくなり、権利的に問題ない音源でも弾かれることが多いのです。そこで、独自に実装することにしました。
音源分離のRoformerというモデルを使ってコーラスと残響を順に外していくと、声があると判定された時間は111.8秒から77.3秒に減り、音高のふらつきは14.1セントから4.6セントになりました。完全ではありませんが、Suno単独でやるよりは改善されました。
ボイスサンプルの雑音を消す
会話をする妻のアバターで使っている「とりちゃん」の声は、SakuraSpeechとIrodoriという音声合成で作っています。このうちIrodoriは数十秒のボイスサンプルを真似て話すのですが、この音源は1988年に撮った8mmビデオで、かなりホワイトノイズが乗っています。
noisereduceという定番の雑音除去をかけると、合成した声の静かな所の雑音は−35dBFSから−60dBFSまで下がりました。しかし、完全に除去できたわけではアリア戦。
帯域の補完:足りない高域を描き足す
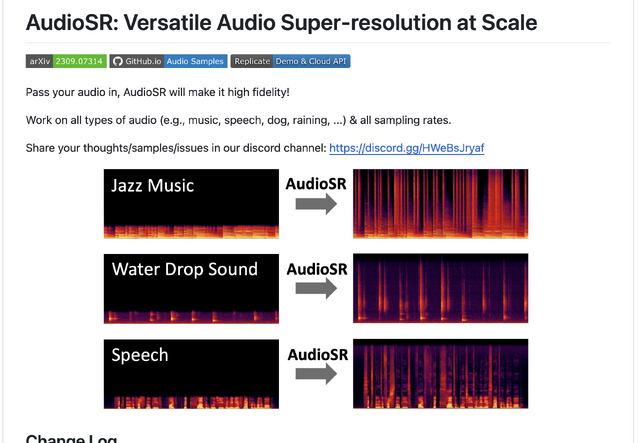
もう一つの課題が帯域です。MP3やSunoの音源は、16kHzあたりでスパッと切れています。この崖の上を描き足す道具として、筆者のもう一台のマシンで動いている動画アプリ「LaViale」には、AudioSRというモデルを使った「音質」ボタンがあります。
このAudioSRには以前から注目しているのですが、後続の研究はほとんど出てこず、リポジトリもほとんどアップデートされないまま。
音声合成関係者が世界中から集まったADC Japan 2026でも、「オーディオのスーパーレゾリューション技術、出てこないですかね?」と聞きまくったのですが、やはりオープンな技術としては公開されていないようです。クローズドで研究はされていると思うのですが。
指示文で音を編集できるAuKというモデルも試しました。ところが、内部で必ず24kHzに落として処理する作りで、12kHzより上を作れません。素材の帯域の上限(中央値13.2kHz)より天井が低く、試した4本すべてで帯域がかえって減りました。
引き算の限界
こうして並べると、どれも「あるものから要らないものを引く」道具です。雑音を引く。コーラスを引く。残響を引く。帯域の補完も、崖の上に「足す」ように見えて、崖の下の音には手を付けません。
引き算は、引くものと残したいものが分かれていれば効きます。しかし、古い録音では、雑音と声が同じ帯域に重なり、声そのものの高い成分が最初から録音されていません。引けば声も削れ、残したいものはもともと存在しない。ない袖は振れぬのです。
Sidon:音声を作り直す道具
Sidonは、東京大学の猿渡・齋藤研究室の中田亘さんらが2025年9月に公開した音声復元モデルです。論文「Sidon: Fast and Robust Open-Source Multilingual Speech Restoration for Large-scale Dataset Cleansing」はICASSP 2026に採択されています。重みはMITライセンスでHugging Faceに置かれています。
仕組みは二段です。まず、雑音の乗った音声から、w2v-BERT 2.0という音声の基盤モデルを微調整した特徴予測器で「きれいな音声ならこうなるはずの特徴」を予測します。次に、その特徴からボコーダで48kHzの音声を合成します。
つまり、元の波形から雑音を引くのではありません。中身を読み取って、きれいな録音として「作り直す」のです。Googleの社内モデルMiipherに並ぶ性能で、論文によれば1枚のGPUで実時間の最大500倍速く動きます。Miipherの論文には、WaveNet開発を主導した全炳河さんの名前がありますね。
MiipherのコードはGoogleの外に出ていないので、この技術がオープンソースとして公開されていることには大きな意義があります。
とりちゃんのボイスサンプルで試す
最初に試したのは、とりちゃんのボイスサンプルです。noisereduceで雑音を消した版と、Sidonで作り直した版を比べると、声と雑音の比(SNR)は39dBに対して47dB。耳で聴いても、Sidon版はベールが一枚剥がれたような声でした。
いま、Irodori版とりちゃんはSidonで作り直した声で話しています。
一方で、合成した声の後にSidonをかけるのは失敗でした。発音が崩れ、書き起こしの誤りが21.5%に増えました。Sidonは「人間が録音した、汚れた声」を直すモデルで、合成音声の癖は想定外なのでしょう。
ちなみに、筆者のマシン(NVIDIA DGX Spark互換機)では、160秒の歌を16秒で処理しました。実時間の10倍で、論文の500倍には届きませんが、使うには十分です。
歌に使うと、音高が崩れる
では、歌声ではどうか。とりちゃんの歌声5本をSidonに通して、通す前と後の音高を比べました。
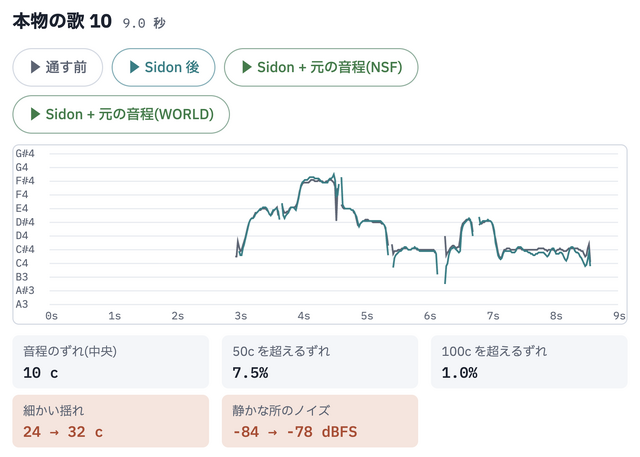
▲歌声とSidonの聴き比べページ
結果は、歌には向かない、というものでした。
半音の半分(50セント)以上ずれたコマが、平均で11.5%。短い区間で音高が上下に揺れる「細かい揺れ」は、元の31セントから66セントに増えました。もともと静かだったオリジナルの歌では、Sidon自身が作り直すときの音により、かえって静かな部分の雑音が増えました。
理由の見当はつきます。Sidonの学習データは話し声(LibriTTS-RとFLEURS-R)です。話し声の音高は、歌ほど長く伸ばしたり、半音単位で正確に保ったりしません。特徴から音声を作り直すとき、音高も「話し声らしく」作り直されてしまうのでしょう。
音高は、元の録音から借りる
ここで、筆者はClaude Codeに問いかけました。
「F0はオリジナルから別途に取っておいて適用するのはどうだろう?」
F0は基本周波数、つまり音高の線です。Sidonで作り直した音から「音色」だけを取り、音高は通す前の録音から取って、両者を組み合わせて合成し直す。
歌声合成の世界には、ちょうどこのための道具があります。
WORLD:音声を、音高(F0)、声道の形(スペクトル包絡)、息の成分(非周期性)に分解して、組み替えて合成し直せる古典的な分析合成系。明治大学の森勢将雅教授が中心となって開発
NSF-HiFiGAN:歌声合成DiffSingerで使われるボコーダ。メルスペクトログラムと音高の線を別々に受け取って音を作る
どちらも、Sidon後の音から音色(包絡やメルスペクトログラム)を、元の音から音高を取って合成しました。
とりちゃんの歌5本の平均 | 50セント超のずれ | 細かい揺れ | 静かな所の雑音 |
|---|---|---|---|
元の歌 | — | 31セント | −67dBFS |
Sidon後 | 11.5% | 66セント | −70dBFS |
Sidonの音色+元の音高(NSF) | 2.7% | 45セント | −72dBFS |
Sidonの音色+元の音高(WORLD) | 2.1% | 39セント | −77dBFS |
元をNSFに通しただけ(天井) | 1.2% | 28セント | −67dBFS |
半音近い外れは、11.5%から2~3%まで減りました。ただし、細かい揺れは元の31セントまでは戻りきりません。Sidonが描き直した倍音の並びが、元の音高とわずかに食い違うためだと考えています。
WORLDは数字の上では一番よく、雑音も下がりますが、少し鼻にかかったような声になることがあります。NSFは素直な声ですが、揺れがやや残ります。どちらがよいかは曲次第なので、両方作って聴き比べることにしました。
Cross Road Bluesで試す
いよいよ本題です。Cross Road BluesのTake 1、2分40秒で試しました。
手順は4段です。
歌とギターを分ける(BS-Roformer)
分けた歌声をSidonで作り直す
元の歌声の音高で組み立て直す(WORLDとNSF)
ギターと混ぜ直す(歌とギターの釣り合いは元の録音に合わせる)
歌声 | 5kHzより上 | 10kHzより上 | 50セント超のずれ |
|---|---|---|---|
分けた歌声 | −35dB | −51dB | 基準 |
Sidon後 | −25dB | −40dB | 12.4% |
Sidonの音色+元の音高(WORLD) | −27dB | −42dB | 6.0% |
Sidonの音色+元の音高(NSF) | −25dB | −40dB | 8.6% |
Sidonは5kHzより上を約10dB戻し、それは音高を組み立て直しても残りました。違いは主に、子音と息の存在感に出ます。
音高の外れは半分ほどに減りましたが、とりちゃんの歌ほどは下がりません。90年前の録音では、音高を測ること自体があやしいのかもしれません。あるいは、ジョンソンの特徴である歌い方(ベンド)が、まっすぐに直されているのかもしれません。ここはまだ切り分けられていません。
ギターの帯域も戻す:崖が無いなら、作ればいい
歌がきれいになると、今度はギターが1936年のままなのが気になります。ここでAudioSRの出番です。
ところが、そのまま通しても効きませんでした。
ギター | 4~6k | 6~8k | 8~12k | 12~16k | 16~24k | 静かな所の高域 |
|---|---|---|---|---|---|---|
分けたギター | −32 | −46 | −49 | −51 | −54 | −22dB |
そのままAudioSR | −32 | −46 | −49 | −48 | −27 | −4dB |
4kHzで切ってからAudioSR | −24 | −24 | −25 | −30 | −33 | −23dB |
(単位はdB。鳴っている所の全体に対する各帯域の量)
そのまま通すと、聴こえ方に効く5~12kHzはまったく埋まらず、16kHzより上にだけ大きな山ができました。しかも静かな所でも高域が大きい。楽器の音ではなく、針の音を「サー」に広げていたのです。LaVialeの「✨音質」に通しても、同じ傾向でした。
AudioSRは、MP3の16kHzのような「スパッと切れた崖」の上を描き足すよう学習されています。1936年に録音されたギターのサウンドは、3kHzあたりからなだらかに暗くなり、その上に針の音が残っている。崖が見つからないので、上の端だけを触っていたわけです。
それなら、人工的に崖を作ればいい。
AudioSRに渡す前に、4kHzより上を急峻に切り落としました。針の音も一緒に落ちます。すると、4~12kHzが−24dB前後まで埋まり、上に向かってなだらかに下がる、自然な形になりました。静かな所の高域は元と同じで、雑音は増えていません。高域が音の大きさに合わせて動くので(相関0.21→0.59)、弦の倍音として描かれています。
5kHzで切ると、上にまたサーが出ました。どこで切るかは、素材の帯域に合わせる必要がありそうです。
VoxScoreの「Vocal Restore」
こうしてできた手順を、VoxScoreのタブ「Vocal Restore」にまとめました。
使い方は簡単です。
古い録音を落とす(wavでもmp3でも、ステレオでもよい)
曲まるごとなら「歌と伴奏を分ける」と「伴奏の帯域も戻す」を入れる。声の高さを男声か女声から選ぶ
「作り直す」を押す
処理はDGX Spark互換機で動き、3分の曲で10分ほどかかります。結果は、伴奏と混ぜ直したもの2本(歌をWORLDで作ったものとNSFで作ったもの)、歌だけのもの、Sidon後、分けた歌声、帯域を戻した伴奏、元の伴奏が並び、それぞれ聴き比べて書き出せます。
1982年に妻と、大学の学園祭(外語祭)で演奏したライブをカセットレコーダーで収録した劣悪な音源も、妻のMC部分はくっきりと再現されています。
これだけでもやった価値はありました。
著作権について
古い録音を扱うので、権利の話を書いておきます。法律の専門家ではないので、あくまで筆者の理解です。
古い歌を自由に使うには、録音の権利と、曲や詞の権利の両方が切れている必要があります。日本では、1967年までに発行された録音の権利は切れています。曲と詞は作った人の没年で決まります。Cross Road Bluesは、日本では録音も曲も保護期間が終わっていると考えられます。
ただし、アメリカでは事情が違います。1923~1946年に発行された録音は発行から100年間保護されるため、Cross Road Bluesの録音はアメリカでは2037年末まで保護されます。そのため、この記事の聴き比べはニコニコ動画に置いています。
ブルースの女王(日本のブルースの女王、淡谷のり子ではなく)と呼ばれ、ジャニス・ジョップリンが墓石を寄付するほど深く敬愛したベッシー・スミスの「Baby, Won't You Please Come Home」は、米国でも著作権保護期間が終わっているため、YouTubeでも公開することができます。そこで、LaViale MV制作システムを使ってミュージックビデオにしてみました。
SP盤由来のAMラジオ的音源を聴いたときには特に感じなかったのですが、リストアした音源には、ジャニスの歌声はベッシー・スミスに近いものを感じます。もちろん、当時の生の歌声がこのとおりであった保証はないのですが。
AIによる楽曲高音質化のこれから
いま、3分の曲を作り直すのに、手元のDGX Sparkでおよそ10分かかります。内訳は、歌と伴奏を分けるのに4~5分、ギターの高音を描き足すAudioSRに約4分。Sidonと音高の作り直しは、合わせて1~2分です。重いのは、音源分離と、拡散モデルで高音を描き足すところです。
Sidon自体は、論文によれば実時間の500倍速く動くモデルです。分離や帯域の補完も、速いモデルが次々に出てきています。この10分が、曲の長さより短くなる日は、そう遠くないかもしれません。
そうなれば、聴き方が変わります。古い録音を聴いていて、音がこもっていて惜しいと思ったら、その場で作り直して、今の録音の音で聴く。ストリーミングサービスのプレイリストを流すように、音質に不満のある曲を、次々と作り直しながら再生していく。
そんな未来が来るかもしれません。
※この記事は、Claude Codeとの対話によりClaude Opus 5.5が執筆したものを筆者が整理・加筆したものです。
参考資料:
Wataru Nakata, Yuki Saito, Yota Ueda, Hiroshi Saruwatari「Sidon: Fast and Robust Open-Source Multilingual Speech Restoration for Large-scale Dataset Cleansing」ICASSP 2026