



生成AIグラビアをグラビアカメラマンが作るとどうなる? 連載記事一覧
9月に登場した生成AI画像系2つ
1つ目は9月20日、Alibaba QwenチームからQwen-Image 2.1がオープンでリリースされた。ComfyUIもゼロデイ対応。ここのところ動画生成MiniMax H3の話が多かったので、コミュニティは一気に盛り上がった。概要は以下の通り。
アーキテクチャ
画像生成部は7Bパラメータ、Single-Stream DiT 32層構成
Block-causal attentionを採用
テキストエンコーダーにQwen3-VL 8B(Vision-Language Model)を使用
64チャンネルRGBA VAE(16倍空間圧縮)を搭載し、透過画像をネイティブに扱う
主な特徴
テキスト→画像生成と画像編集を単一モデルに統合(従来は別モデルだった
ネイティブ透過(RGBA)対応: アルファチャンネル付きの透過画像を直接生成・編集可能
ネイティブ2K解像度、複数アスペクト比(1:1, 4:3, 16:9 など)に対応
編集機能が豊富
リファレンス画像を最大10枚まで使用可能
円形描画・ペイント注釈・マスク指定によるローカル編集
人物・製品のアイデンティティ保持編集
パノラマ、インフォグラフィック、絵コンテ(ストーリーボード)生成にも対応
mixed-granularity attentionとprefix KVキャッシュ再利用により、低計算コストで高品質を実現
このようになかなかの性能なのだが、最大の問題はライセンス。
現状、研究用途限定・非商用ライセンス。商用利用にはAlibabaとの別途契約が必要となっており、原稿料が発生する記事や既に収益がある、例えばXのアカウントでの紹介も該当するのか? など同社に問い合わせが殺到しているらしく、今のところ不明ということで残念ながら作例の掲載は見送った。
筆者は既にいろいろな画像を生成をしているが、t2iに関しては平面的、コントラストが浅い、気持ちノイジーといった感じでKrea 2の方が好み。LoRA作成に関してはai-toolkitが対応済みだ。
ただi2iつまりリファレンス画像を使った編集はかなり優秀。最大10入力でもしっかり参照し画像を生成する。以下、Workflow。リファレンス画像はKrea 2。生成結果は載せていないのでセーフと言ったところか(笑)。流石にこれだけ画像が並ぶとなかなか壮観だ。
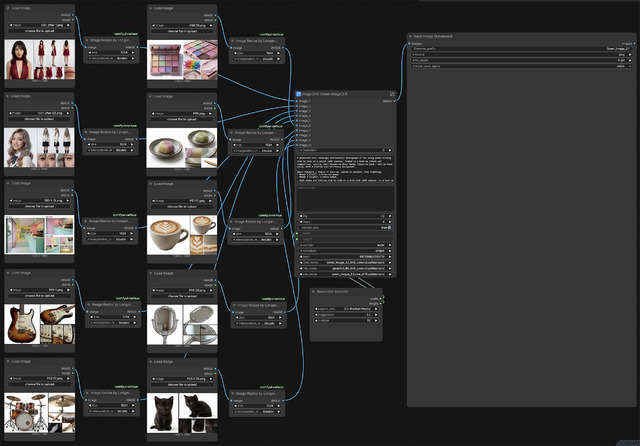
ポイントとしてはリファレンス画像の解像度をあまり高くしないこと。高くても作動はするが、生成に物凄く時間がかかる。長辺1024px辺りにリサイズするのがいいだろう。
Workflowやモデルに関してはComfyUIの標準テンプレートにあるので、そちらを参考にしてほしい。
Ming Image 0.1 - Ming-Image-0.1-Design
Qwen-Image 2.1がライセンスの関係で記事にできず今月のネタ困った……と悩んでいた矢先、思いもよらぬ伏兵がオープンしかもMITライセンスでAnt Group(inclusionAI)からMing Image 0.1として9月22日にリリースされた。
こちらも元を正せばAlibaba関連。同時期に同関連から違うものが出るという面白い事態になっている。ComfyUIの正式対応は24日。モデルとしてはMing-Image-0.1-Design / Ming-Image-0.1-Design-Layerの2種類。
まずMing-Image-0.1-Designから。主な特徴は以下の通り。UI/UXデザイン用に特化したオープンで画像生成モデルは初ではないだろうか?
テキストが読める必要のあるテキストリッチなデザインに特化したt2iモデル
UI画面、インフォグラフィック、ポスターなど、UI/UXのデザインが得意
テキストを含む構図全体を生成
RGBA出力に対応(背景が透過、白背景にならない)
構造化プロンプト最大8Kトークンまで対応
パラメータ数: 6B
推奨設定: 2048×2048(高速化したい場合は1024×1024)、サンプリングステップ12、CFGスケール1.0
ところがUI/UXのデザイン用だけでなく、リアルな人物系も意外と行ける。更に無検閲(笑)。絵柄的には先のQwen-Image 2.1は軟調なのに対し硬調。個人的にはこちらの方が好みだったりする。LoRAもai-toolkitが対応済み。モデルとWorkflowは以下の通り。
モデル
https://huggingface.co/Kijai/Ming-Image-ComfyUI
Workflow(t2i/i2i)
https://github.com/user-attachments/files/32585937/ming_image_test_01.json
https://github.com/user-attachments/files/32585994/ming_image_edit_test_01.json
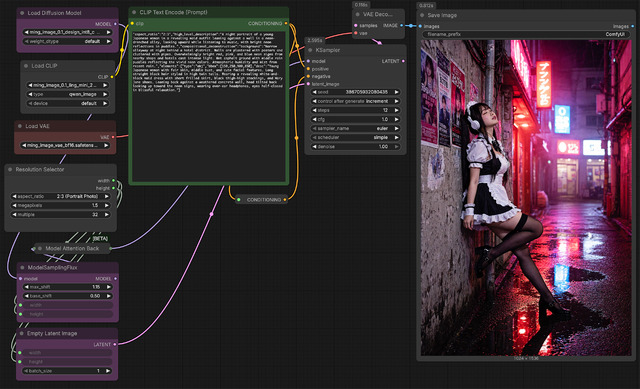
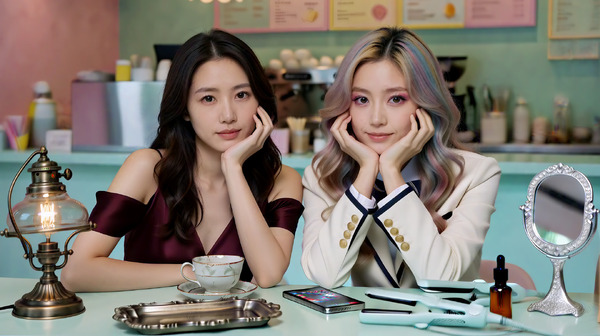
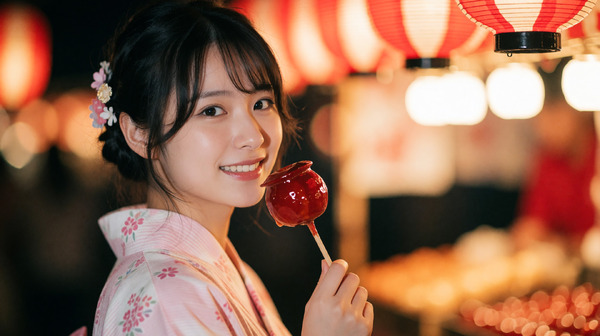
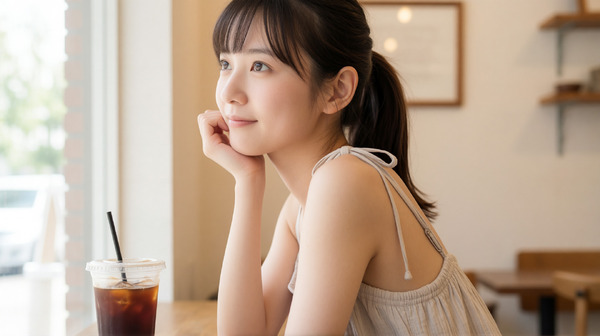
作例を4掲載。一部デザインっぽいのも入れてある。
 | 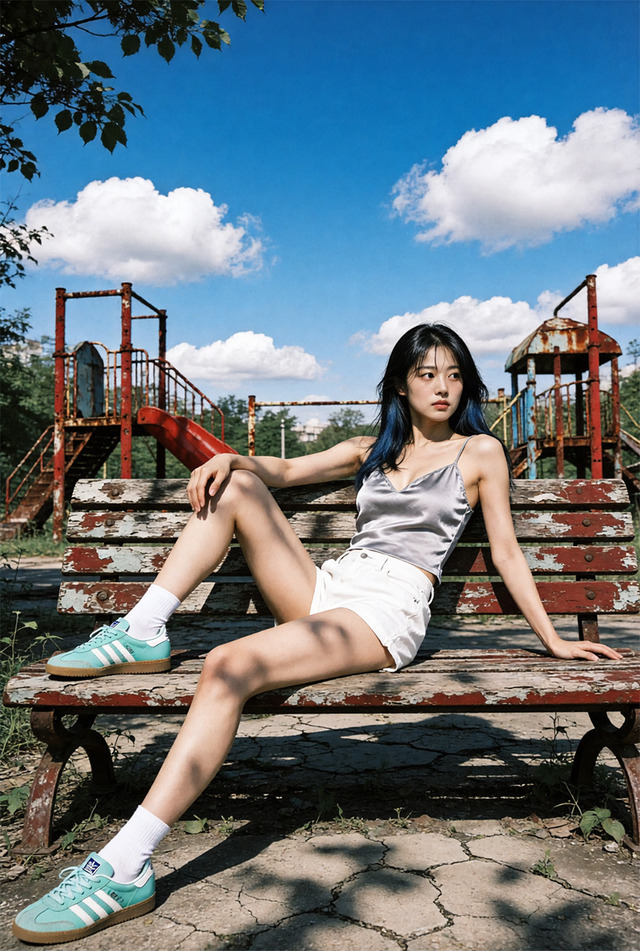 |
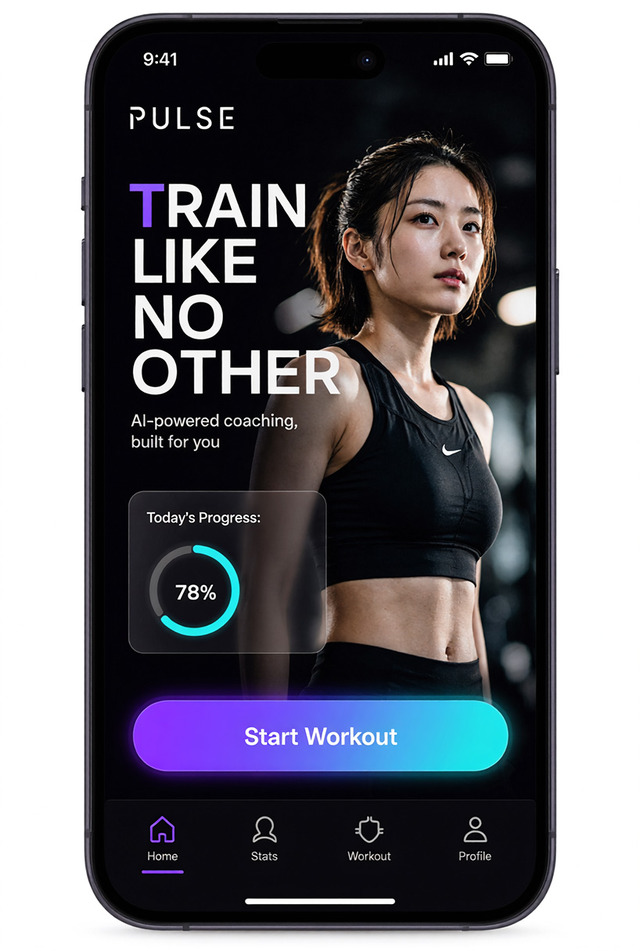 | 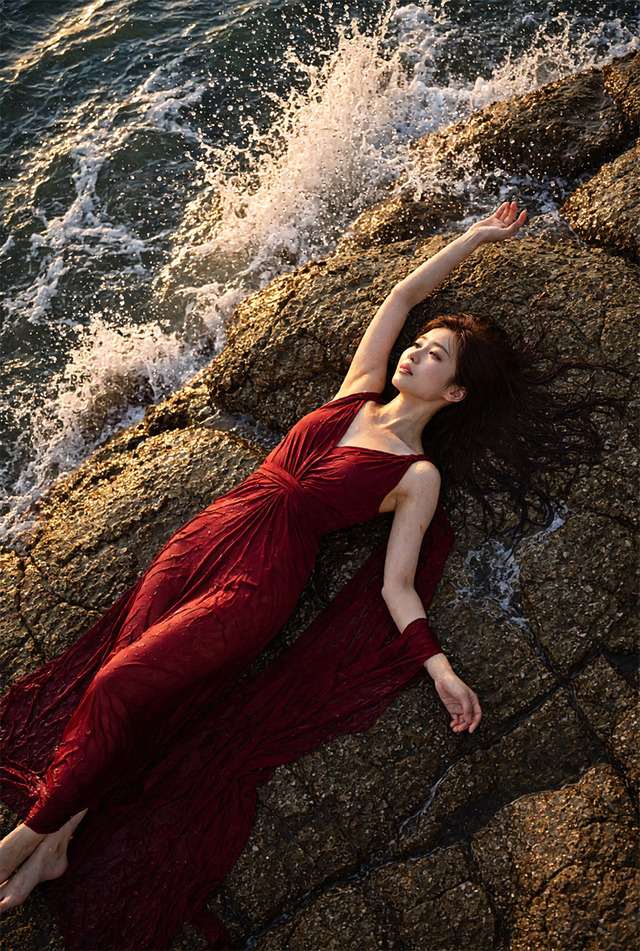 |
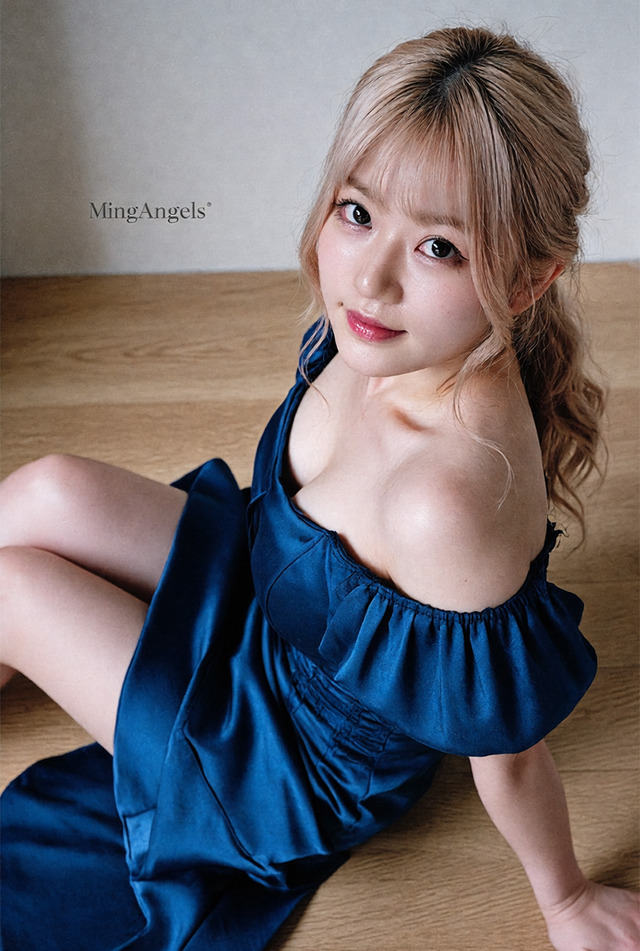
いかがだろうか? UI/UXのデザインが得意と言う割にリアル系もなかなか行ける。自作LoRAもばっちりOK(1枚目)。
Workflowはよくある一般的なものであるが、MODEL間にModelSamplingFlux 1.15/0.50が入ってるところが違う。ここのwidth/heightに関しては2048/2048固定でいいのか? 生成する画像に合わすのか? ここのところが良くわからない。
どちらにしても結果は同じ。余計に悩ましいところ。Model Attention Backendは速くなるおまじないだと思ってほしい。
また裏技になるが、Z-Image用のLoRAも使える。特にZ-Image Baseから学習したLoRAの方が顔LoRAに関しては似るようだ。
God Kijai氏によると、”Ming-Image-0.1-DesignのDiTはZ-Imageをベースにファインチューンし、テキストエンコーダを新規に差し替えたものとのこと。”
Kijai describes the base as Z-Image derived with a new text encoder.
The DiT is a 30-layer, 3840-dimension design with 16 input channels and 2x2 patching, paired with a separate vision-language encoder and its own connector.
なるほど納得といった感じだ。いずれにしてもZ-Image用のLoRAは山ほどあるのでいろいろ試してみるといいだろう。
次にMing-Image-0.1-Designはリファレンス画像を使ったi2iにも対応。(ComfyUIの実装では)最大8つ。ただ試した範囲では3つまでが無難な感じか。
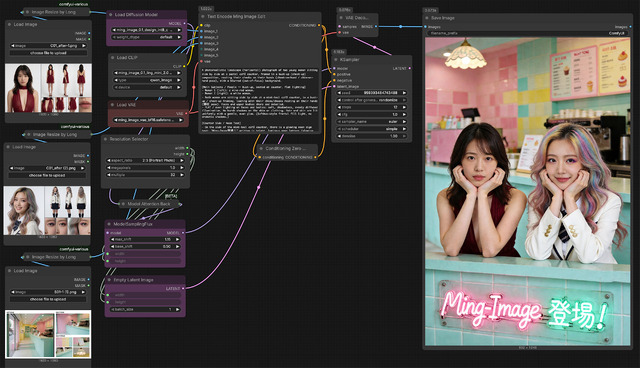
以上のようにMing-Image-0.1-Designは、UI/UXデザイン系に限らずリアルな人物もうまく生成でき、i2iもOK。12 stepsなので生成も速い。これからいろいろ環境が整うと化ける可能性があり、しかもまだバージョンは0.1。今後が楽しみなモデルではないだろうか。
Ming Image 0.1 - Ming-Image-0.1-Design-Layer
次はMing-Image-0.1-Design-Layer。執筆時、公式なWorkflowが見つからず手探り状態なのだが、名前の通り、入力画像をレイヤーで分けることが出来る。(仮)Workflowは以下の通り。
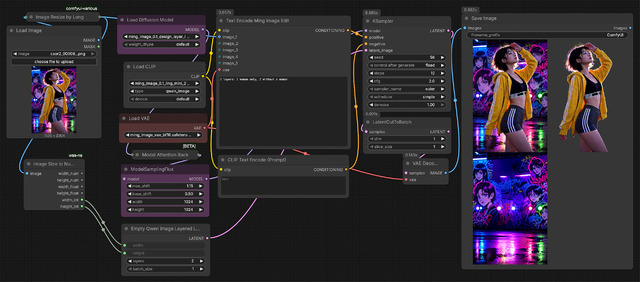
元画像から人物と背景に分かれている。人物の周囲は透明なので重ねると元画像になる。Ming-Image-0.1-Designと違うのは、Empty Qwen Image Layered Latentを使う、VAE Decodeの前にLatentCutToBatch(t/1のまま)を入れる、PromptはText Encode Ming Image Editを使う。
また12 stepsでいいがCFGは2.0。つまり生成に関してはこれだけでMing-Image-0.1-Designの倍時間がかかる。
Promptの書き方は
Number of layers: N
Layer 1: <front-most layer>
Layer 2: <...>
Layer N: <background/environment layer>
と言う感じだ。Empty Qwen Image Layered Latentの数字をこのNumber of layers: Nの数字に合わす。
ただWorkflowが未完成なのか、もともとそうなのか不明だがSeedによってうまく行ったり行かなかったり…。公式のWorkflowを待ちたいところ。
今回締めのグラビア
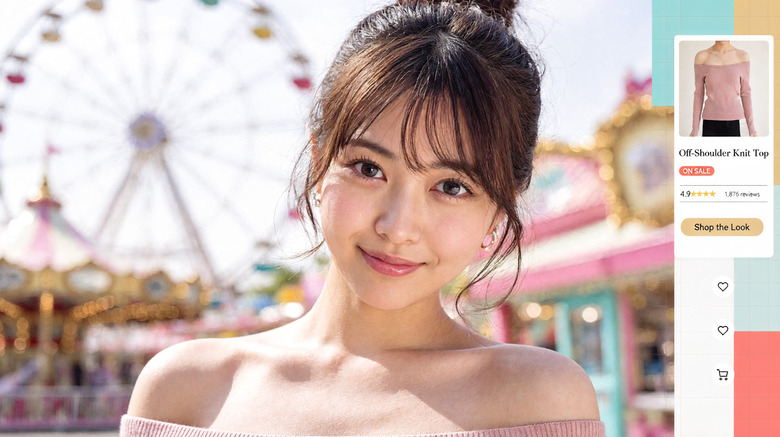
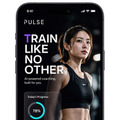
今回締めのグラビアは、扉、グラビア共にこのモデルの特徴らしくUI/UX風に……と、ちょっとこれまでにはないパターンにしてみた。
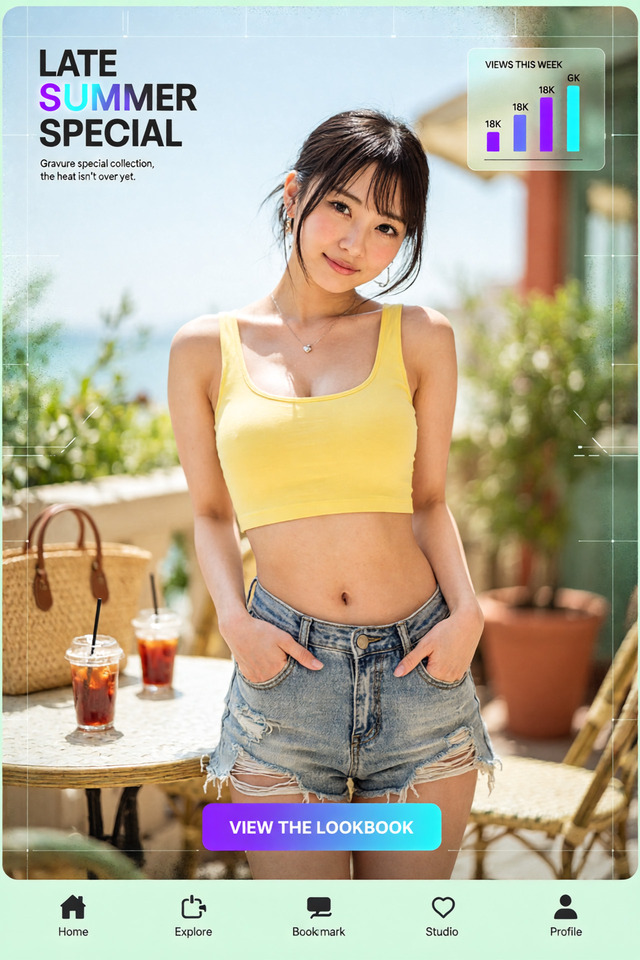
そろそろ9月も終わり。夏が過ぎると一気に加速する感じで、今年も残すところ10、11、12月のみ。この3カ月の間に何か大物は出るのだろうか!?