

Anthropicは米国時間9月22日、AIモデル「Claude Opus 5.5」の提供を開始しました。
新たな「Claude 5.5」ファミリーの最初のモデルで、同社の各サービスとAPIのほか、Amazon Web Services、Google Cloud、Microsoft Azureでも利用できます。

■Fable級の性能でOpus 5より4割安
Opus 5.5は多くの作業で上位モデル「Claude Fable 5.1」並みの性能を発揮し、一般的な作業ではOpus 5より運用コストが40%下がるとAnthropicは説明しています。発表のポイントは、
・性能:エージェント型コーディング、コンピューター操作、知識労働のベンチマークで首位
・対GPT-6 Astra:標準のエフォート設定のまま、Astraの最高スコアに並ぶか上回る項目が複数。1タスクあたりのコストはAstraの約5分の1から4割程度
・価格と速度:API単価は入出力とも20%値下げ、キャッシュ読み出しは60%値下げ。出力速度は30%以上向上
・使い勝手:Pro、Max、Teamなどサブスクの5時間あたり利用上限を引き上げ。文章は結論先出しで、Claude語や用語が減り読みやすく
・安全性:同社の行動監査で過去最高スコア。一方、サイバーセキュリティと生物学の領域はFable 5.1並みの制限付きで、判定された作業は下位モデルが引き継ぎ
■性能:Fable 5.1を上回るが「差はスコアほどではない」(Anthropic)
AnthropicのAIモデルラインナップでは、Opusの上位に「Mythos」系のモデル群があり、Fable 5.1はその一つに追加の安全対策を施したモデルです。Opus 5.5は、従来の上位モデルと肩を並べる位置づけで登場しました。
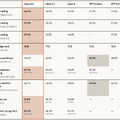
同社が公表したベンチマークでは、コマンドライン上での複雑な作業を測るTerminal-Bench 4.0でOpus 5.5が66.4%となり、Fable 5.1の55.8%、Opus 5の52.3%を上回りました。44職種の実務を評価するGDPval-AA v2.1では1846(Eloスコア)で、Fable 5.1の1735、Opus 5の1708を上回っています。コンピューター操作のOSWorld 2.0でも81.8%と、Fable 5.1の80.7%をわずかに上回りました。
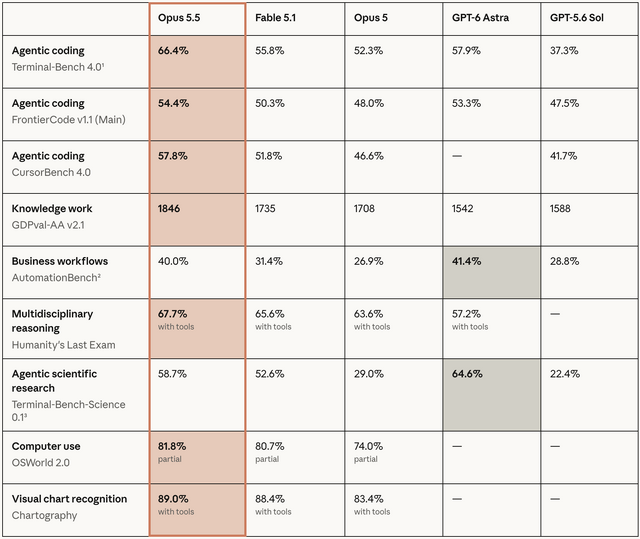
ただし、同社自身がこの数字の読み方に留保を付けています。この水準の能力になるとベンチマーク上の差は実際の差を示す指標として信頼性が下がってきたとし、社内での利用ではFable 5.1との差はスコアが示すほど大きくないと述べています。
また評価はセーフガードを有効にした状態で行われ、セーフガードが介入した場面では別のモデルが作業を引き継いだため、スコアは低めに出ている可能性があるとしています。
■GPT-6 Astra比較:標準「medium」で最高スコアに並び半額以下
コーディング分野で注目を集めたOpenAIの「GPT-6 Astra」との比較も示しています。Opus 5.5は思考量をlow、medium、high、xhigh、maxの段階で調整でき、標準はmediumです。
Terminal-Bench 4.0ではAstraの57.9%に対し、Opus 5.5はxhigh設定で66.4%と8.5ポイント上回りました。標準のmedium設定でもAstraと同等のスコアを、1タスクあたり約40%のコストで達成したとしています。
実際にマージされるコード変更を書けるかを測るFrontierCodeでは、medium設定のOpus 5.5が54.6%となり、Astraの最高スコア53.3%を約5分の1のコストで上回ったとしています。ただし差は1.3ポイントと小幅。
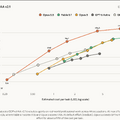
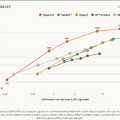
知識労働のGDPval-AA v2.1でも、medium設定のOpus 5.5がmax設定のAstraを約5分の1のコストで上回ったとしています。
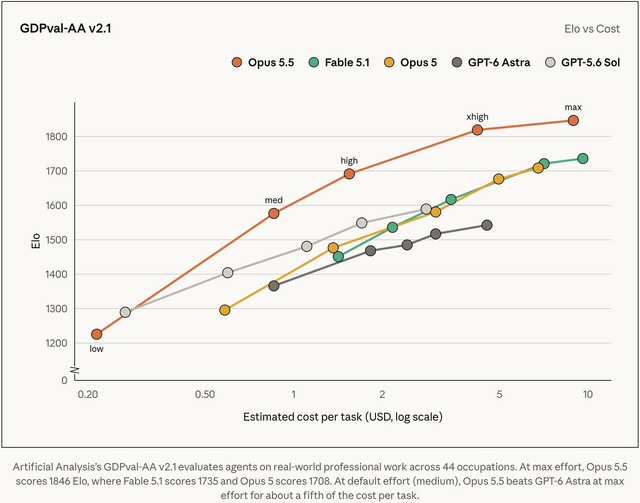
(▲画像:GDPval-AA v2.1では、Opus 5.5のmed設定でGPT-6 Astra max設定を上回り、コストは1/5)
一方、Astraが上回った項目もあります。複数のアプリをまたぐ業務自動化を測るAutomationBenchではAstraが41.4%、Opus 5.5が40.0%。科学研究タスクのTerminal-Bench-Science 0.1ではAstraが64.6%、Opus 5.5が58.7%。
Anthropicは、AutomationBenchは運営元のZapierが実施し、セーフガードの介入を失敗として数えたため、実利用より低いスコアになったと注記しています。
API単価で比べると、OpenAIが公表するAstraの標準価格は100万トークンあたり入力10ドル、出力50ドル。Opus 5.5は入力4ドル、出力20ドルで、いずれもAstraの4割の水準です。
Anthropicが示す1タスクあたりのコスト差は、このトークン自体の単価差に、1タスクで消費するトークン量の少なさが重なった結果と考えられます。なお、Astra側の数値の多くはOpenAIの公表値を引用したもので、測定条件は両社で完全にはそろっていません。
■コーディング:数十万行規模の移行や、夜通しの無人作業で差
Anthropicは、Opus 5.5がコードベース全体の移行や監査のような、長く広範な作業に特に強いとしています。早期テスターの1人は68万行のコード移行を1日未満で完了しました。別のテスターは20万行のコードベースの監査と修正を3時間未満で終え、Opus 5では20時間以上かかり、トークンも2.5倍消費したといいます。
社内テストでは、Webトラフィックの負荷分散ソフト「HAProxy」をC言語からRustへ書き換えさせました。Opus 5.5とFable 5.1はどちらもHAProxy自身の回帰テストをほぼすべて通過しましたが、所要時間はOpus 5.5が9.5時間、Fable 5.1が12時間で、コストは51%少なかったとしています。
Claude Codeを長時間使う層に響きそうな声もあります。Stripeのエンジニアは、積み重なった40件のプルリクエストのリベースで、1つのOpus 5.5セッションが十数の別セッションを指揮し、翌日午後には40件すべてがCIを通過したと述べています。Clioのエンジニアは、6つのリポジトリにまたがる作業を一晩無人で任せたところ、18時間以上作業を続けたとしています。
思考量を下げても質を保てる点も繰り返し強調しています。Factoryは、medium設定を標準で使おうと思えた初めてのモデルだとし、Opus 5のhigh設定と同等の結果を、出力トークン20~25%減で得たと評価しています。Deloitteによれば、最も低い設定でもコードレビューで既知バグの72%を検出し、high設定のOpus 5(56%)を上回りました。
Claude CodeとClaude Platformでは、最大2.5倍速で動く高速モード(Fast mode)も利用でき、料金は100万トークンあたり入力8ドル、出力40ドルです。
■コスト:トークン20%~60%値下げ、使用量も低減
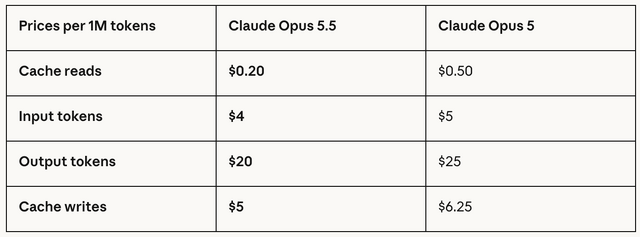
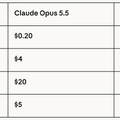
API価格(100万トークンあたり)は
・入力:4ドル(Opus 5は5ドル)
・出力:20ドル(同25ドル)
・キャッシュ読み出し:0.20ドル(同0.50ドル)
・キャッシュ書き込み:5ドル(同6.25ドル)
入出力とキャッシュ書き込みは20%、キャッシュ読み出しは60%の値下げ。同社によれば、キャッシュ読み出しはエージェント作業やコーディングにかかるコストの大半を占めるといいます。
単価の引き下げに加えて1タスクあたりのトークン消費も減るため、同社のテストでは標準設定の一般的な作業でOpus 5より40%安くなり、出力の生成速度もOpus 5より30%以上速くなったとしています。
サブスクリプション利用者向けには、Pro、Max、Team、シート制のEnterpriseの各プランで5時間あたりの利用上限を引き上げます。
あわせてレート制限のリセットを付与し、保存して好きなタイミングで使えるようになっています。1か月の期間限定で繰り越しもできないので、抱えたまま期限切れにしないよう注意。
■文章:結論を先に、専門用語は控えめに
Opus 5に多く寄せられた意見の一つが文章の分かりにくさだったとして、Opus 5.5では書き方を大きく改善しました。重要な情報を冒頭に置き、専門用語や独特の言い回しを減らし、利用者が指定した文章ルールにも従うとしています。
発表内の比較例では、請求額が減った原因の調査報告で、Opus 5がコードの説明から入るのに対し、Opus 5.5はまず「減少分のうち1.50ドルは無料枠の変更、残る9.92ドルはリファクタリング時のバグによるもの」と内訳を示してから技術的な説明に移っています。
Rampのエンジニアは、冗長で追いにくい出力がこれまで最大の不満だったが、Opus 5.5でそれが解消したと述べています。Anthropicは、作業内容を追いやすく検証しやすいことは安全面の利点でもあるとしています。
■安全性:行動監査は過去最高。生物学・サイバー攻撃・蒸留対策セーフガード搭載
アライメント(AIが意図通りにふるまうか)について、Anthropicは約2,000のシナリオで評価する自動行動監査で、不適切な行動のほぼすべての指標において近年のどのClaudeモデルよりも良い結果だったとしています。
許可された範囲の境界を越えようとする試みはOpus 5やClaude Mythos 5.1より約85%少なく、プロンプトインジェクション攻撃への耐性も、試したすべての設定でOpus 5と同等以上。リリース前にはMETRなど外部機関の評価も受けています。
一方で同社は、Opus 5.5が評価中であることを察知して振る舞っている兆候も見られたため、実環境での動作を見極めにくくなっているとも認めています。
Opus 5.5はOpusとして初めて、Fable 5.1と同クラスのセーフガードをサイバーセキュリティ、生物学、蒸留(大量のアカウントを使ってモデルの能力を抜き取る行為)対策の3分野で搭載しました。
サイバーセキュリティ分野では、通常の開発の中でのバグ発見や修正はOpus 5.5で行えますが、多くのセキュリティ関連タスクはOpus 4.8に回されます。
一般の利用者にとって重要なのは、無害なはずのタスクがセーフガードに誤認され止められてしまう問題がどの程度発生するか。発表には誤検知がどの程度減ったかを具体的に示す数字はありません。むしろベンチマークの注記からは、コーディングや業務自動化の評価中にもセーフガードが介入し、Opus 4.8やOpus 5が代わりに作業した場面があったことが読み取れます。
なおOpenAIもGPT-6 Astraについて、追加の安全チェックが正当な作業を遅らせたり止めたりすることがあり、APIでは作業が停止すると説明しています。
セイバー攻撃への悪用懸念から特定組織への提供となった Mythos のように、専門用途向けの窓口も用意します。生物学研究に使いたい審査済みの組織は「Life Sciences Verification Program」に申請でき、サイバーセキュリティの実務家向けには「Cyber Verification Program」の対象を今後数週間のうちにOpus 5.5へ拡大する予定です。
■提供・価格
Claude Opus 5.5は米国時間9月22日から、Amazon Web Services、Google Cloud、Microsoft Azureを含む全プラットフォームですでに利用できるようになっています。APIのモデル名は「claude-opus-5-5」で、価格は100万トークンあたり入力4ドル、出力20ドル。
開発者向けの変更として、Opus 5.5では思考(thinking)モードをオフにできなくなりました。また蒸留対策として、2026年8月31日以降に作成されたAPIアカウントには、過去の文脈を書き換えて思考内容を引き出す操作を防ぐ「preserved thinking」が適用されます。ゼロデータ保持にも対応します。
同じClaude 5.5ファミリーの「Claude Sonnet 5.5」と「Claude Haiku 5.5」も、今後数週間のうちに登場する予定です。