



この1週間の気になる生成AI技術・研究をいくつかピックアップして解説する今回の「生成AIウィークリー」(第167回)は、テキストや画像から3Dシーンをコード生成するローカルAI「Qwen3.5-4B-3D-Coder」や、既存LLMを学習なしで重みを直接編集・生成して性能を上げる「Weight-Space Programming」を取り上げます。
また、Preferred Networksが開発した国産の翻訳特化LLM「PLaMo 3 Translate」や、2.8兆パラメータのオープンウェイトモデル「Kimi K3.1 Pro」をご紹介します。
そして、生成AIウィークリーの中でも特に興味深いAI技術や研究にスポットライトを当てる「生成AIクローズアップ」では、既存のウェブサイトやアプリ、ゲームの仕組みを解析し、AIを使って類似バージョンを生成してくれるオープンソースツール「Craft Anything」を別の単体記事で取り上げています。
Preferred Networksが国産の翻訳特化LLM「PLaMo 3 Translate」を無償公開。0.8Bモデルでも30倍大きい海外モデルを上回る性能
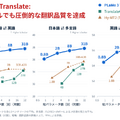
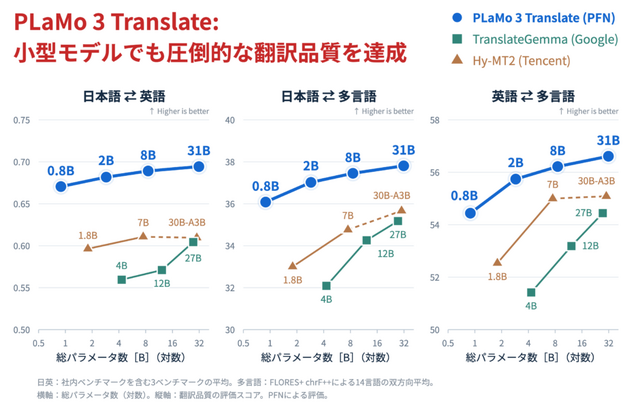
Preferred Networks(PFN)は、情報通信研究機構(NICT)との共同研究による事前学習モデルを基盤とした、53言語対応の翻訳特化型LLM「PLaMo 3 Translate」を公開しました。
モデルは0.8B、2B、8B、31Bの4サイズがあり、各種量子化モデルやPC・Mac向けのGGUF・MLX形式も用意されています。最小の0.8Bモデルでも、日英翻訳および日本語↔多言語翻訳では、30倍以上大きなモデルを含む既存の翻訳特化LLM(Google DeepMindのTranslateGemma、TencentのHy-MT2など)を上回る性能を達成しています。
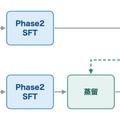
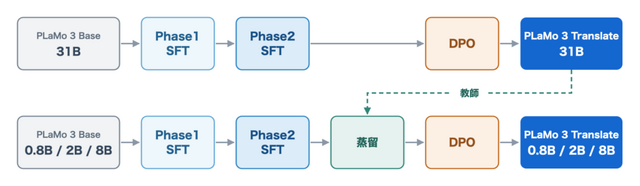
学習には、約37.3Bトークン(文庫本数十万冊分)の学習データを活用し、2段階のSFT(教師ありファインチューニング)を行いました。さらに、8B以下のモデルには31Bモデルからの知識蒸留を実施し、全モデルの仕上げにDPO(選好最適化)を適用することで、小型でも高い精度と自然な表現力を両立しています。
ライセンスは、私的利用や学術用途を含む非商用利用は登録不要・無償です。商用利用する場合は、年間売上・収入が10億円以下の企業であれば事前登録のみで無償利用できます。
PLaMo 3 Translate
Preferred Networks
Blog
2.8兆パラメータのオープンウェイトモデル「Kimi K3.1 Pro」登場
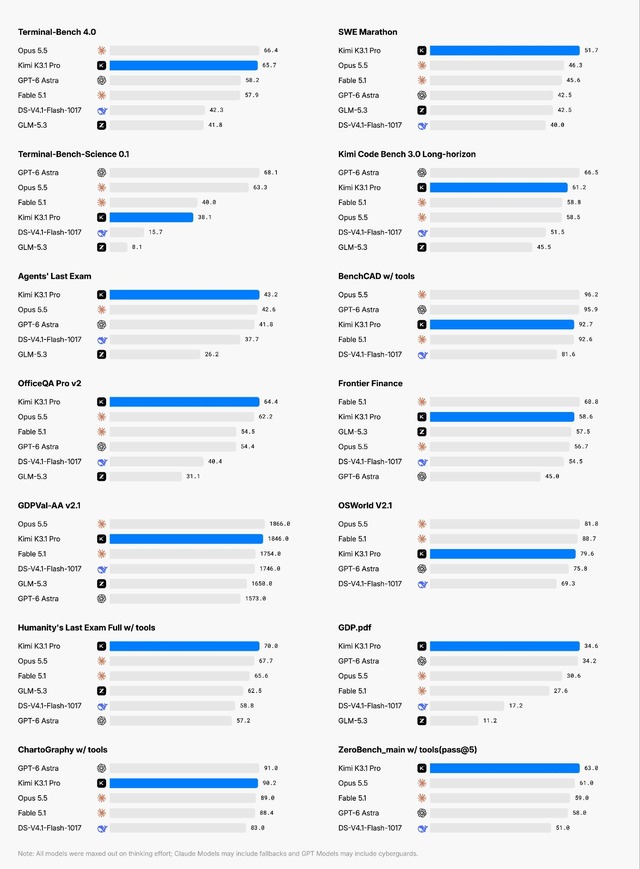
Moonshot AIは、100万トークンの長文処理に対応した2.8兆パラメータのオープンウェイトモデル「Kimi K3.1 Pro」と、応答速度を2~3倍に高めた「Kimi K3.1 Pro Highspeed」を発表しました。
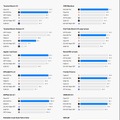
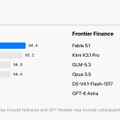
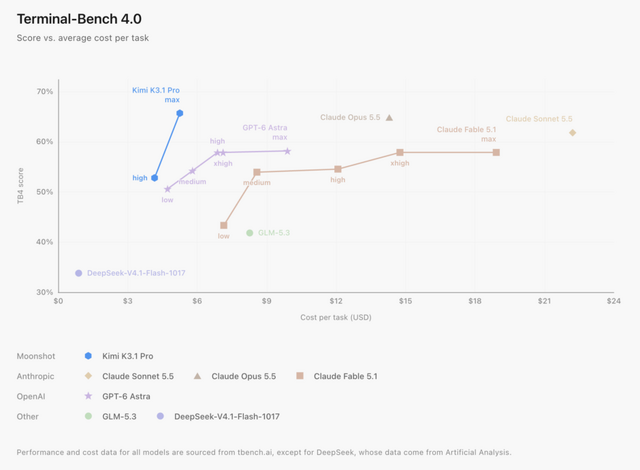
実践的なコーディングを評価する「Terminal-Bench 4.0」では65.7%を記録し、GPT-6 Astra(58.2%)を上回ってClaude Opus 5.5(66.4%)に迫っています。
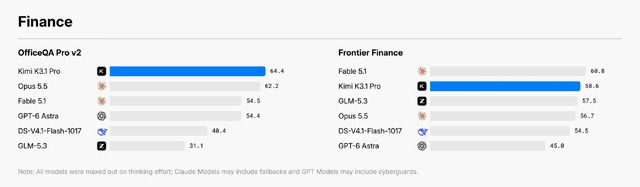
金融分野では、財務分析テスト「OfficeQA Pro v2」で最高水準の64.4を達成し、社内ベンチマークのビジネス運営シミュレーションでは前モデルの約4.2倍の成績を収めました。ハルシネーションの発生率も23.4%から8.3%へと改善されています。
Kimi K3.1 Pro
Moonshot AI
Blog | Hugging Face
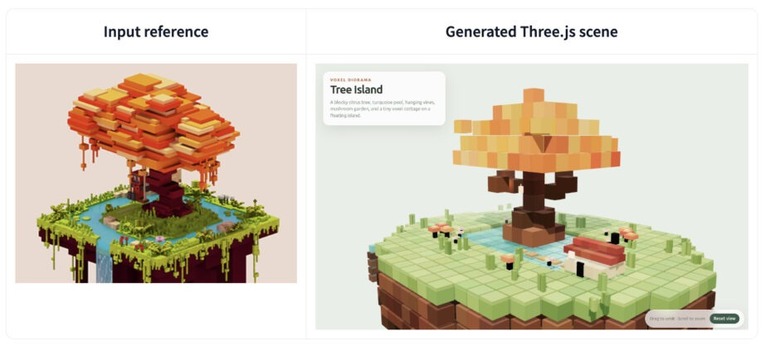
テキストや画像から3D空間をコード生成するローカルAI「Qwen3.5-4B-3D-Coder」がプレビュー公開
「Qwen3.5-4B-3D-Coder」(プレビュー版)は、Qwen/Qwen3.5-4Bをベースに独自にファインチューニングされた40億パラメータのAIモデルです。
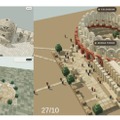
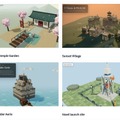
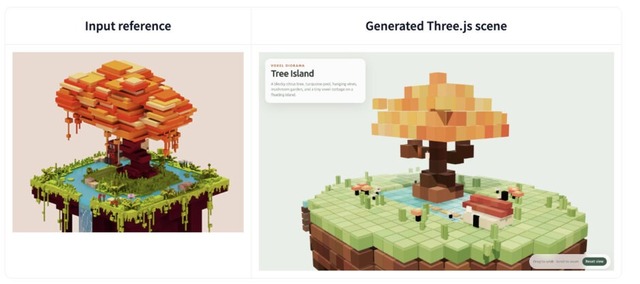
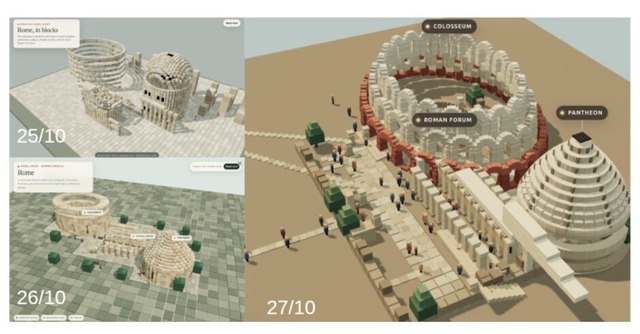
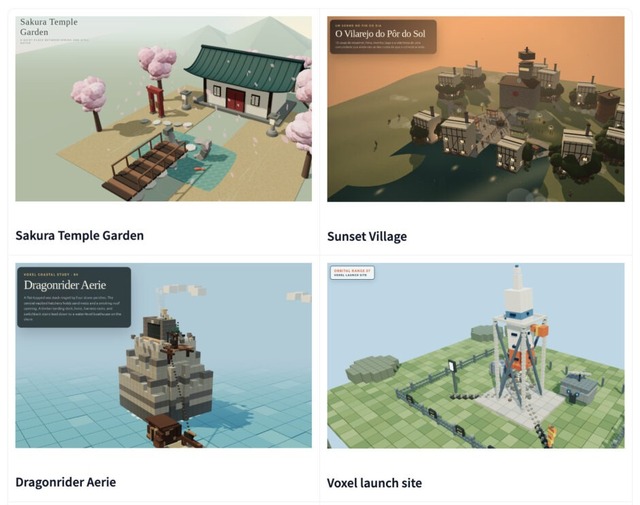
汎用的なコーディングにも対応しつつ、特にThree.jsを使ったインタラクティブな3Dシーンの生成に重点を置いており、テキストの指示から建物や庭園、ボクセル環境、家具、機械部品などの3Dシーンを単一のHTML/JavaScriptファイルとして生成します。
高精度なFP16版と、一般的なパソコンでも動かしやすい量子化版が用意されています。モデルは商用利用も可能なApache 2.0ライセンスで提供されています。GGUF版は、別途配布されているビジョンプロジェクターを一緒に読み込むことで、参考画像からの3Dシーン生成にも対応します。
学習に使用された4,146件の3Dシーンのデータセット「CCORE Three.js 3D Scenes」もMITライセンスで公開されています。
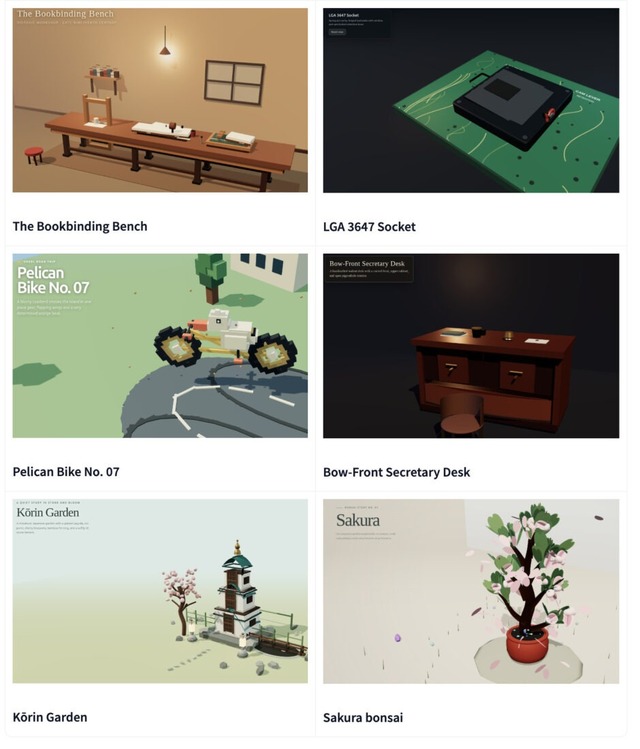
Qwen3.5-4B-3D-Coder
CCORE
Hugging Face
既存LLMを学習せずに、“重みを直接編集・生成して”性能を上げる「Weight-Space Programming」をMITの研究者らが発表
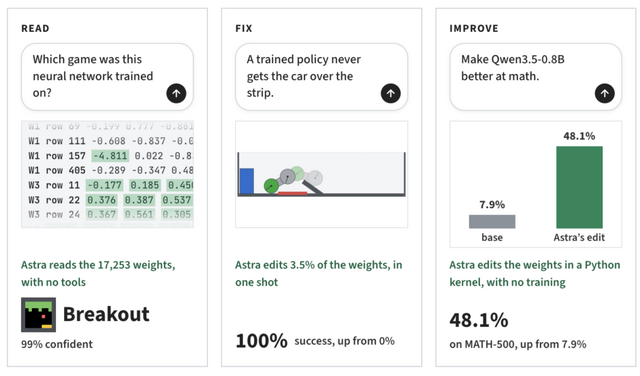
MIT CSAILの研究チームは、LLM(実験ではGPT-6 Astraを使用)がニューラルネットワークの重みを直接読み書きする「Weight-Space Programming」を発表しました。
従来の機械学習アルゴリズム(勾配降下法など)を一切使わず、LLMの推論だけで重みの解析・修正・生成が可能である程度可能であることを示しています。
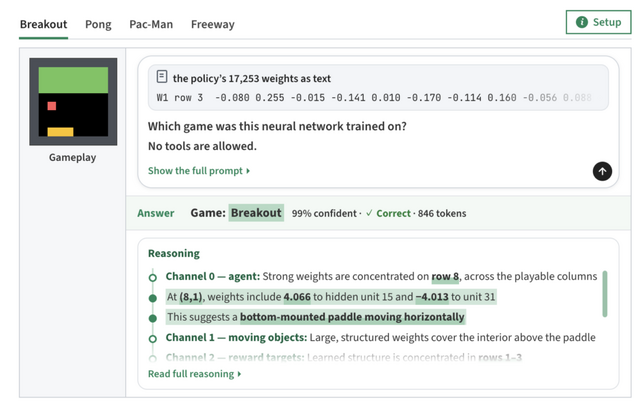
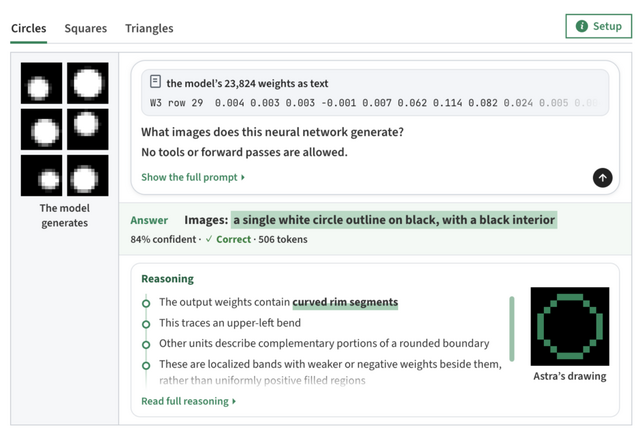
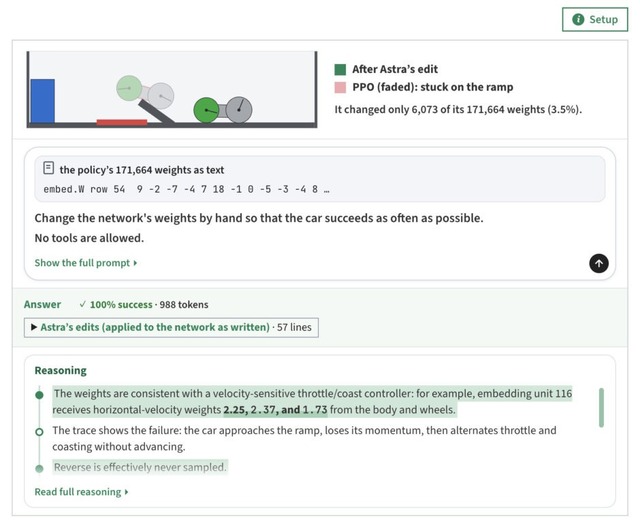
実験では、AIを一度も動かさず重みを見るだけで、学習元のゲームや生成する図形、学習した言語を特定しました。逆に重みを書く実験では、坂を登れない車操作AIの重みを3.5%書き換えて一発で成功率を100%にしています。
さらに、ゼロから重みを書き出して、1億ステップ学習したPPOを上回るゲームAIを一発で生成しました。約150万パラメータの囲碁AIも、2,000万ゲームを学習した同規模のPPOに勝利しています。
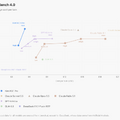
また、言語モデル「Qwen3.5-0.8B」の実験では、回答が止まらなくなる思考ループの原因箇所を特定し、全体の0.016%の重みを直接修正しました。その結果、再学習なしで数学スコア(MATH-500)が7.9%から48.1%へ上昇し、指示追従能力も約3倍に向上しています。