

Anthropicは米国時間9月28日、AIモデル「Claude Sonnet 5.5」の提供を開始しました。9月22日に登場したOpus 5.5に続く「Claude 5.5」ファミリーの2番目のモデルで、Claudeの各アプリとAPIのほか、Amazon Web Services、Google Cloud、Microsoft Azureでも利用できます。
■ Opus 5.5に迫る性能で3割速く、最大3割安
Anthropicによれば、Sonnet 5.5を前モデルSonnet 5からの明確なアップグレード。出力は30%以上速く、多くの作業でコストが最大30%下がるとしています。
比較表では性能面でもOpus 5.5との差は小さく、Sonnet 5.5は「速くて安いだけ」のモデルではなくなっています。
使い分けとしては、慎重な判断が要る複雑な作業では依然としてOpus 5.5が優る一方、範囲のはっきりした日常的な作業やバグ修正、完成度の高い文書・スライド・表計算の作成にはSonnet 5.5など、補い合う関係を想定しています。
・性能:多くの評価でSonnet 5を上回り、一部は劇的な伸び。比較表の8項目のうち、Terminal-BenchではOpus 5.5を上回り、実務評価のGDPval-AAは2点差。多くの項目で3ポイント程度以内まで迫る
・コストと速度:API単価は据え置きのまま、使うトークンが減って1タスクあたり最大30%安く。出力は30%以上速く、Sonnet史上最速
・文章とデザイン:Opus 5.5と同様に文章が分かりやすく、用語控えめで結論から簡潔に話せるように。UIの仕上げやテンプレートに沿ったスライド作成でも品質向上
・安全性:アライメントと誠実さの指標は大半でSonnet 5と同等以上。Sonnetとして初めて、高リスクなサイバー関連の依頼を別モデルに切り替えて処理する方式に
・競合:API単価が同じOpenAIの「GPT-6 Sol」に対し、知識労働系の評価で大きく上回る
■性能:Terminal-Benchは10.3%から70.6%に
Anthropicによれば、Sonnet 5.5はあらゆる分野でSonnet 5を上回り、一部では劇的に伸びています。象徴的なのがコマンドライン上での複雑な作業を測るTerminal-Bench 4.0で、Sonnet 5の10.3%から70.6%へと大きく伸びました。
コンピューター操作のOSWorld 2.1では80.1%(Sonnet 5は57.0%)、グラフ読み取りのChartographyでは61.6%(同15.6%)です。
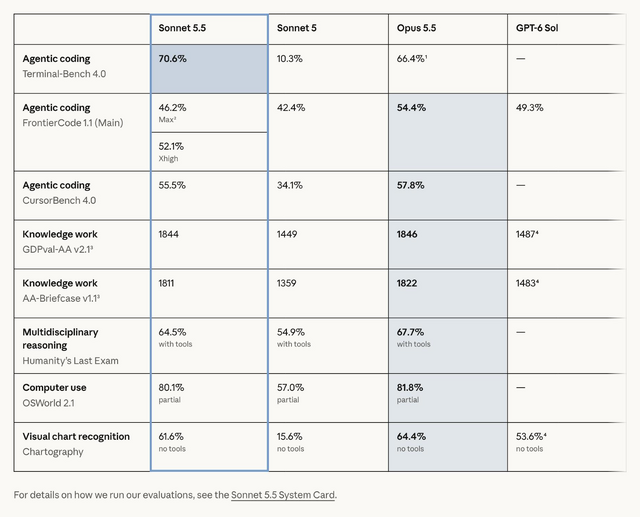
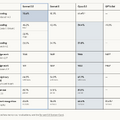
【画像】Sonnet 5.5、Sonnet 5、Opus 5.5、GPT-6 Solのベンチマーク比較(出典:Anthropic)
上位のOpus 5.5との差も、Anthropicの比較表を並べて見ると小さくなっています。44職種の実務を評価するGDPval-AA v2.1ではスコア1844で、Opus 5.5の1846と2点差、Sonnet 5を約400上回りました。長時間の知識労働を測る新しいAA-Briefcase v1.1でも1811と、Opus 5.5の1822に11点差です。
比率で示される評価でも、CursorBench 4.0は55.5%対57.8%(2.3ポイント差)、OSWorld 2.1は80.1%対81.8%(1.7ポイント差)、Chartographyは61.6%対64.4%(2.8ポイント差)、ツール併用のHumanity's Last Examは64.5%対67.7%(3.2ポイント差)、xhigh設定のFrontierCode 1.1は52.1%対54.4%(2.3ポイント差)でした。
比較表の上では、Terminal-Bench 4.0でOpus 5.5の最高スコア66.4%(xhigh設定)を上回っており、表の8項目のうち、逆転が1項目、残る7項目の差は最大でも3ポイント台前半かAA-Briefcaseの11点にとどまります。
Anthropicはこの並びを「Opus 5.5並み」とは表現していませんが、Sonnet 5との比較だけでなくOpus 5.5との差で見ても、Sonnet 5.5が大きく賢くなったことが数字から読み取れます。スクリーンショットだけを頼りに「ポケットモンスター 赤」をクリアした初のSonnetモデルにもなったといいます。
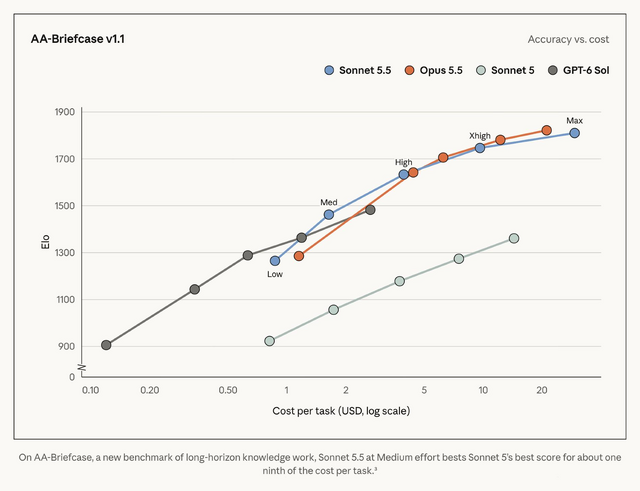
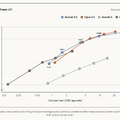
【画像】長時間の知識労働を測るAA-Briefcase v1.1の、思考設定ごとのスコアと1タスクあたりのコスト(出典:Anthropic)
ただし同社自身は、Sonnet 5.5をOpus 5.5の代わりとしては打ち出していません。ベンチマークは能力の一面しか捉えておらず、持続的な判断を要する複雑で自由度の高い作業ではOpus 5.5が明らかに上回るというのが、社内と外部テスターの評価だとしています。
また、Sonnet 5.5が上回ったTerminal-Benchの比較は、Sonnet 5.5側の思考設定が表に明記されていません。
■コストと速度:単価は据え置き、使うトークンが減る
API価格(100万トークンあたり)はSonnet 5から据え置き。
・入力:2ドル(Opus 5.5は4ドル)
・出力:10ドル(同20ドル)
・キャッシュ読み出し:0.20ドル(同0.20ドル)
・キャッシュ書き込み:2.50ドル(同5ドル)
単価は変わらないものの、同じ作業に必要なトークンが大幅に減るため、同社のテストでは1タスクあたりのコストがSonnet 5より最大30%低減できたとしています。出力の生成速度も30%以上向上し、Sonnetとして過去最速としています。
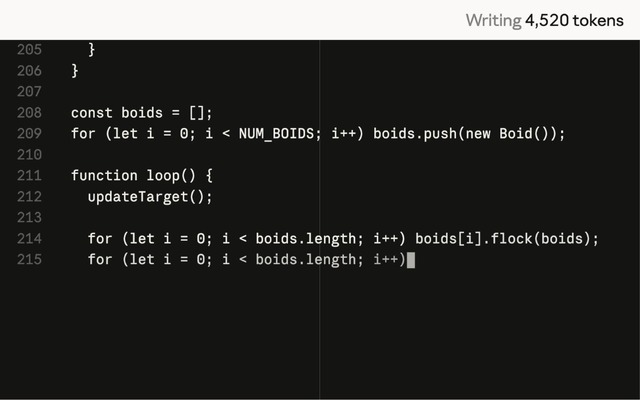
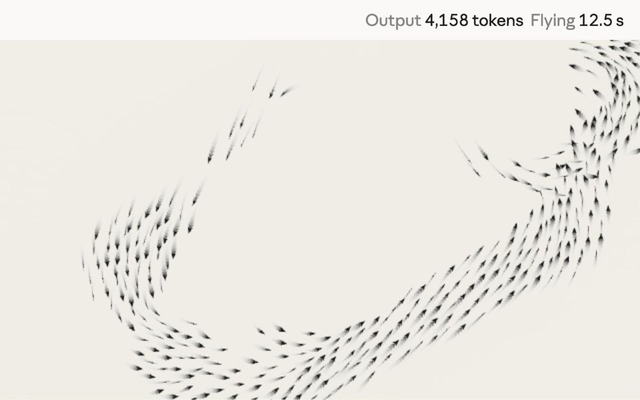
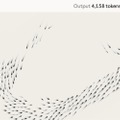
【画像】「400羽のムクドリの群れを1つのHTMLファイルで」という同じ指示のデモ。Sonnet 5(4a)がまだコードを書いている(4,520トークン)一方、Sonnet 5.5(4b)は4,158トークンで出力を終え、群れが飛んでいる(出典:Anthropic)
思考量(effort)はlow、medium、high、xhigh、maxの5段階で、標準はClaude CodeとClaudeのアプリがmedium、API(Claude Platform)がhighです。同社によれば、複数の評価でlowやmedium設定のSonnet 5.5が、Sonnet 5の最高スコアを約10分の1のコストで上回りました。
一方で、高い設定ではOpus 5.5と同程度のコストで同程度の性能になりうるとしており、Opus 5.5との使い分けでコスト面の強みが生きるのは低めの設定で使う場合です。
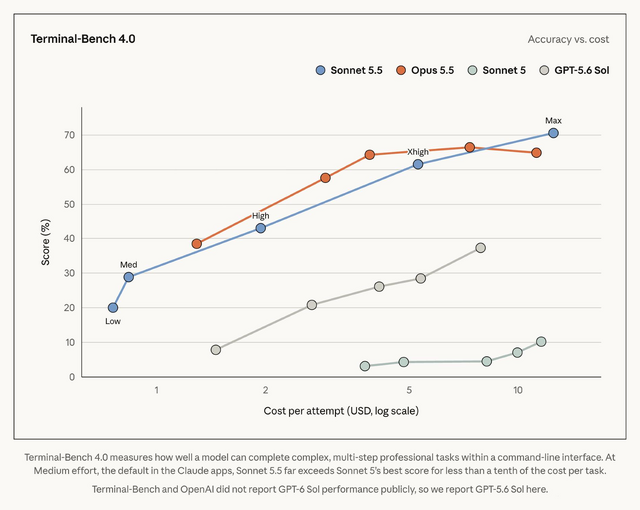
【画像】Terminal-Bench 4.0の思考設定ごとのスコアと1タスクあたりのコスト。GPT-6 Solは公開スコアがないため前世代のGPT-5.6 Solを表示(出典:Anthropic)
企業の評価でも、トークン消費の少なさが目立ちます。Balyasny Asset Managementは、2,441件の金融タスクでSonnet 5を上回りつつ、1回答あたりのトークン数はSonnet 5の約49.7万に対し約12.1万と、およそ4分の1だったとしています。Boxは、Sonnet 5より正確で2.4倍速かったと評価しました。
■GPT-6 Solとの比較:単価は同じ、知識労働で大差
OpenAIが9月22日に投入したGPT-6 Solは、最上位のGPT-6 Astraの下に位置する中位モデルです。API価格は100万トークンあたり入力2ドル、出力10ドルで、Sonnet 5.5と同額。
Anthropicの比較表では、GDPval-AA v2.1でSonnet 5.5の1844に対しGPT-6 Solは1487、AA-Briefcase v1.1では1811対1483と、知識労働系の評価で大きな差が付いています。Chartographyも61.6%対53.6%でSonnet 5.5が上回りました。
実際にマージされるコード変更を書けるかを測るFrontierCode 1.1では、xhigh設定のSonnet 5.5が52.1%で、Solの49.3%を2.8ポイント上回りました。API標準のhigh設定でも、Solの最高スコアに約5分の1のコストで並んだとしています。
なおmax設定では46.2%とxhighより低く、同社はサブエージェントを多用した結果、時間切れや課題の範囲外の編集が起きたためと説明しています。
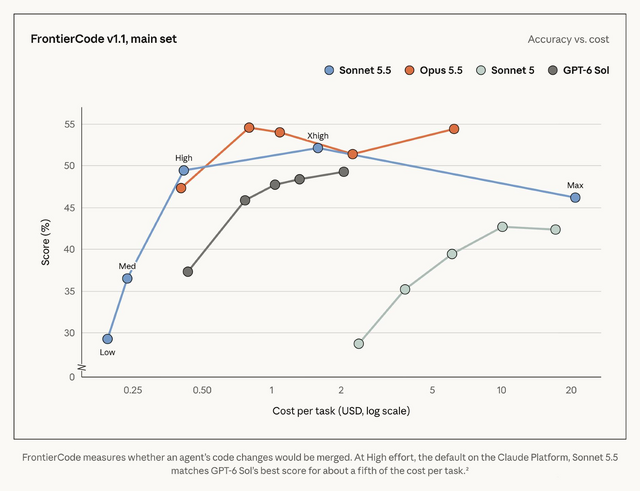
【画像】FrontierCode 1.1の思考設定ごとのスコアと1タスクあたりのコスト(出典:Anthropic)
ベンチマークの見かたとしては留保も。Terminal-Bench 4.0とCursorBench 4.0ではSolの公開スコアがなく、前世代のGPT-5.6 Solとの比較です。OpenAIがSolの画像理解に関わる不具合を最近修正したため、一部の公式スコアは最新版を反映していない可能性があるとも注記されています。一方のOpenAIは、業務自動化のAutomationBenchなどでSolがOpus 5を大幅に低いコストで上回ったと発表しており、両社が比較に選ぶ評価は異なります。
■コーディング:バグ修正と反復が速く、手数も減る
Anthropicは、コーディングでの伸びが特に大きいとしています。FrontierCodeのhigh設定では、同じ設定のSonnet 5より10ポイント高いスコアを、1タスクあたり約15分の1のコストで達成しました。実際のCursorでの作業をもとにしたCursorBench 4.0では55.5%で、Opus 5.5の57.8%に約2ポイント差まで迫っています。
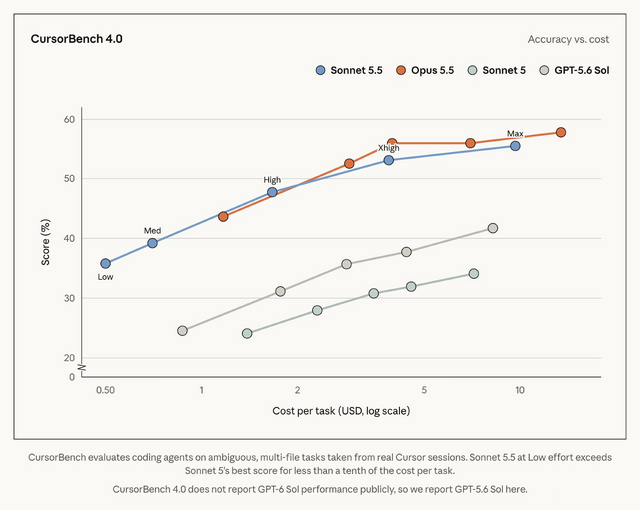
【画像】CursorBench 4.0の思考設定ごとのスコアと1タスクあたりのコスト。GPT-6 Solは公開スコアがないためGPT-5.6 Solを表示(出典:Anthropic)
早期テスターは、コードベースを理解する速さと、ツール呼び出しをまとめて実行して手順が減る点を評価しています。Base44は、118件の実際のアプリ作成でOpus 5と同等の評価のアプリを作り、1件あたりの反復回数は平均3.6回(Opus 5は7.7回)だったとしています。Lovableはツール呼び出しが3分の1減ったとし、CodeRabbitはSonnet 5で目立ったWeb検索の多用とトークン消費の多さが解消したと述べています。Creatorの開発者は、Opus 5.5が設計を決めれば実装はSonnet 5.5に任せられるとしており、両モデルの分担をうかがわせます。
■文章とデザイン:UIの仕上げやスライド作成も得意に
Anthropicによれば、Sonnet 5.5はOpus 5.5と同様、前世代より分かりやすい文章を書くとしています。早期テスターからは、Sonnet 5より共同作業の相手として優れているという声が寄せられ、Everyのデザイナーは、Opus 5.5の自然な文章の改善を一部受け継いでおり、一緒に作業していて楽しいと評しています。速度の速さから、あまり複雑でない作業を素早く繰り返し直していく使い方にも向くとしています。
同社がもう一つ強調するのがデザインのセンスです。ユーザーインターフェースに仕上げの磨きをかけたり、スライドのテンプレートに沿ってほとんど手直しの要らない資料を作ったりできるとしています。社内テストでは、上場企業の四半期決算資料と説明会の書き起こし、スライドのテンプレートを渡して10枚の業績レビューを作らせたところ、2人の専門家が初稿をそのまま送付できる水準と判断しました。
■安全性:Sonnet初の「別モデルへの切り替え」、ただし判定の対象は拡大
アライメント(AIが意図通りにふるまうか)について、Anthropicは約1,850のシナリオによる自動行動監査で、Sonnet 5.5はアライメント、悪用への耐性、誠実さの大半の指標でSonnet 5と同等以上だったとしています。サンドボックスから抜け出そうとする頻度はOpus 5.5に近い低さでした。
一般の利用者にとって身近なのは、正当な作業がセーフガードに引っかかる問題です。Sonnet 5.5はサイバーセキュリティ能力が大きく向上したため、最上位モデル群と同様の、別モデルへの切り替えを伴うセーフガードを搭載した初のSonnetになりました。
Sonnet 5にもサイバー関連のセーフガードはありましたが、高リスクと判定された依頼はブロックされていました。Sonnet 5.5ではエクスプロイト生成やペネトレーションテストといった依頼がSonnet 5に切り替わって処理されます。同社は通常のソフトウェア開発は影響を受けないとしており、ソースコードの脆弱性チェックやバグ修正はSonnet 5.5のまま行えます。最先端LLMの開発に関わる一部の作業も、同様にSonnet 5へ切り替わります。
一方、切り替えずにその場でブロックされる対象もあります。Sonnet 5.5はSonnetとして初めて、思考内容を抜き出そうとする蒸留目的の依頼を検知する分類器を備えました。生物学のセーフガードはSonnet 5と同じで、該当すると切り替えずにブロックされます。同社は、微生物学やウイルス学の一部の依頼が誤って判定されることがあると認めています。開発者向け文書でも、Sonnet 5.5はSonnet 5より多くのカテゴリーで依頼を断ると明記されています。
判定の対象は最新のメッセージだけでなく、メモリーやコネクター経由の内容、Web検索の結果、ファイルなどモデルが読むものすべてに及び、利用者が入力していない内容がきっかけになることもあります。切り替わると通知が出て、以降のチャットはSonnet 5のまま続きます。自動切り替えは設定でオフにでき、その場合は会話が一時停止します。APIでは自動切り替えは標準で無効です。
誤検知の頻度がどう変わったかを示すデータは、今回の発表にもありません。作業が止まらず続く場面は増える一方で、判定の対象そのものはSonnet 5より広がっているため、体感の変化は実際の運用を見て判断する必要があります。サイバーセキュリティの実務家向けの「Cyber Verification Program」は、提供開始時点ではSonnet 5.5に対応しておらず、近く申請を受け付ける予定です。
■提供・価格
Claude Sonnet 5.5は米国時間9月28日から、Amazon Web Services、Google Cloud、Microsoft Azureを含む全プラットフォームで利用できます。APIのモデル名は「claude-sonnet-5-5」で、価格は100万トークンあたり入力2ドル、出力10ドル。ゼロデータ保持にも対応します。
開発者向けの変更として、思考をオフにする設定(disabled)は使えなくなり、事前の思考を省く新設定「between_tools」に置き換わります。特定のツールを強制的に呼び出させる指定(forced tool use)も非対応です。また蒸留対策の「preserved thinking」が拡張され、Sonnet 5.5の思考内容は生成したアカウントでしか使えなくなりました。Claude Codeでセッション途中にアカウントを切り替える場合などは挙動が変わります。
Claude 5.5ファミリーの残る「Claude Haiku 5.5」は、大量処理やコスト重視の用途向けとして、今後数週間のうちに登場する予定です。