



この1週間の気になる生成AI技術・研究をいくつかピックアップして解説する今回の「生成AIウィークリー」(第164回)は、Metaが発表した米国製で過去最高性能とうたうオープンウェイトモデル「Muse Spark Open」や、コーディング系評価でGPT-5.6 SolやOpus 5を一部上回る精度のAIモデル「DeepSeek-V4.1-Flash-1017」を取り上げます。
また、iPhoneのメモリ3GBで動く35BのマルチモーダルAIモデル「MiniCPM-V 4.7」や、PlayStation 5でローカルLLMを高速動作させるネイティブアプリ「PS5LM Plus」をご紹介します。
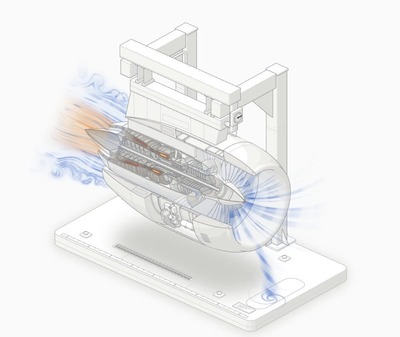
そして、生成AIウィークリーの中でも特に興味深いAI技術や研究にスポットライトを当てる「生成AIクローズアップ」では、技術的なアイデアや抽象的な概念、実際の機械装置の説明などから、それらの仕組みを体現した動く立体図解を生成するAIエージェント用の拡張スキル「Anatomy」を別の単体記事で取り上げています。
Metaが米国製で過去最高性能とうたうオープンウェイトモデル「Muse Spark Open」を公開
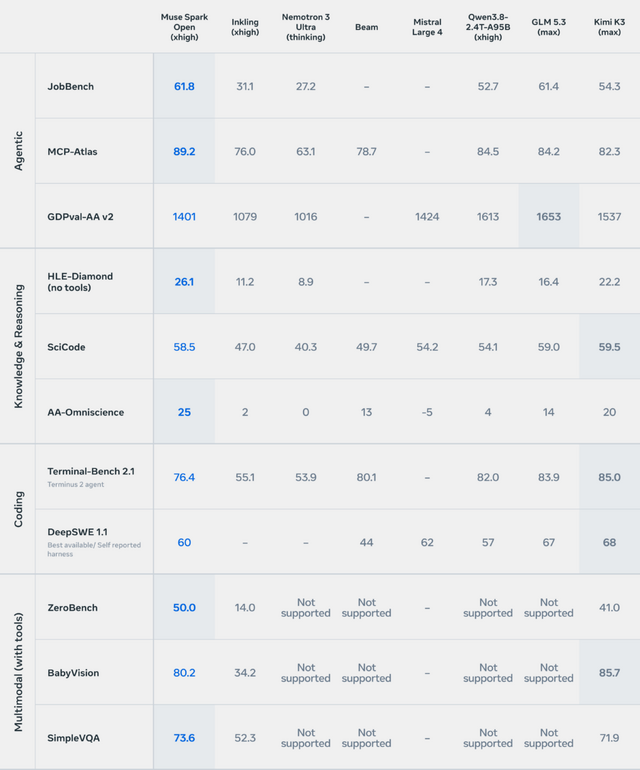
Metaは、米国製オープンウェイトモデルの中で過去最高とうたうオープンウェイトAIモデル「Muse Spark Open」を公開しました。
このモデルは合計8160億パラメータ(推論時に稼働するのは420億)の規模を持ち、一度に100万トークンの情報を処理できるマルチモーダルAIです。特にプログラミングや、AIが自律的に手順を考えて複雑な作業をこなすエージェント業務に強みを持っています。
Muse Spark Openは大規模なモデルでありながら、クラウドを使わずに手元のデスクトップ環境で動かせます。Appleの「MLX」を活用し、M5 Ultraチップ搭載の「Mac Studio」を2台連結させることで、合計1TBの大容量メモリを備えた1台のスーパーコンピュータのように機能します。
実際のテストでも、外部のサーバに頼ることなくMac上だけでiOSアプリのバグ修正や新機能追加を完了させたり、動画編集ソフト「DaVinci Resolve」を自動操作して映像からベストな瞬間を選び出し、縦型動画に切り抜いたりといった作業が実証されています。
Muse Spark Open
Meta
Blog | Hugging Face
iPhoneのメモリ3GBで動く、35BのマルチモーダルAI「MiniCPM-V 4.7」がオープンウェイトで登場
「MiniCPM-V 4.7」は、画像や動画を理解するオープンウェイトのマルチモーダルAIです。主力の「35B-A3B」モデルと軽量な「1B」モデルの2種類が提供されています。このうち35B-A3Bは、MoE(Mixture of Experts)モデルです
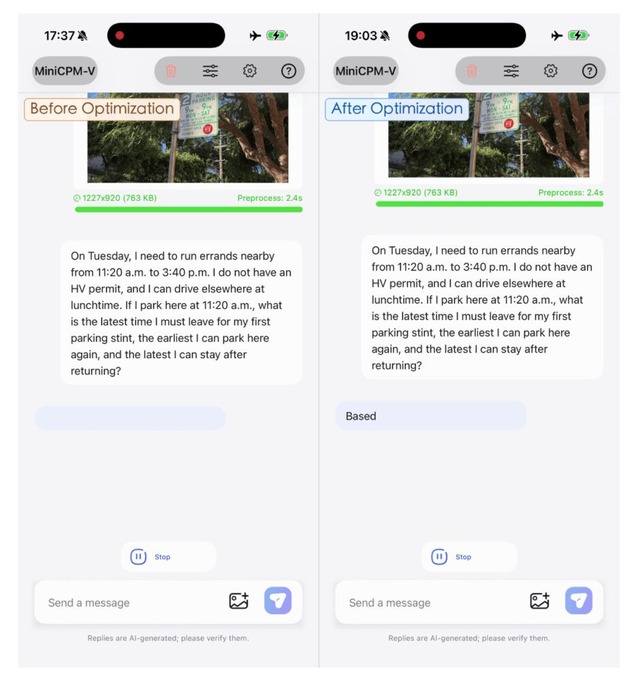
スマートフォンなどの端末上でも動作するのが特徴です。MoEは、処理ごとに必要な専門モジュールだけを呼び出す効率的な仕組みですが、データ量が大きくスマホのメモリに収まらないため、読み込み遅延が課題でした。
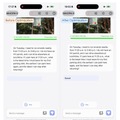
本モデルでは、次に使うモジュールを予測して先読みする技術や、きめ細かなデータ圧縮(量子化)などを組み合わせることでこの遅延を抑え、iPhone 17 Pro Max上で3GBのメモリ使用量・毎秒13トークン以上の速度を達成しています。
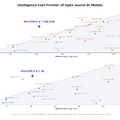
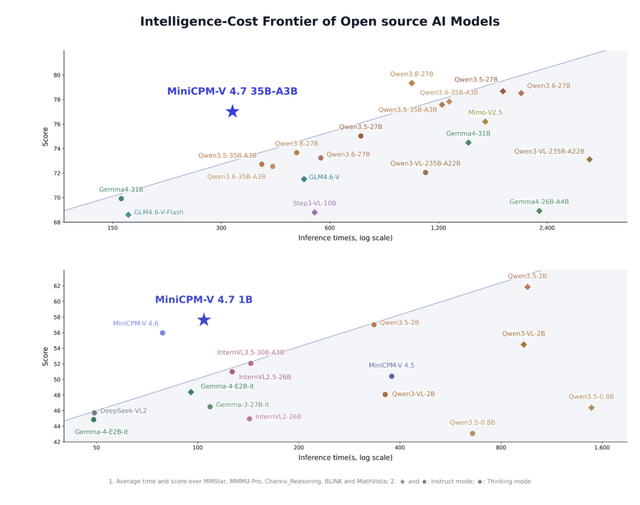
性能面では、Instructモードにおいて、同規模の競合モデル「Qwen3.6 35B-A3B」よりも短い推論時間でより高い総合スコアを達成しました。
MiniCPM-V-4.7
openbmb
GitHub | Hugging Face
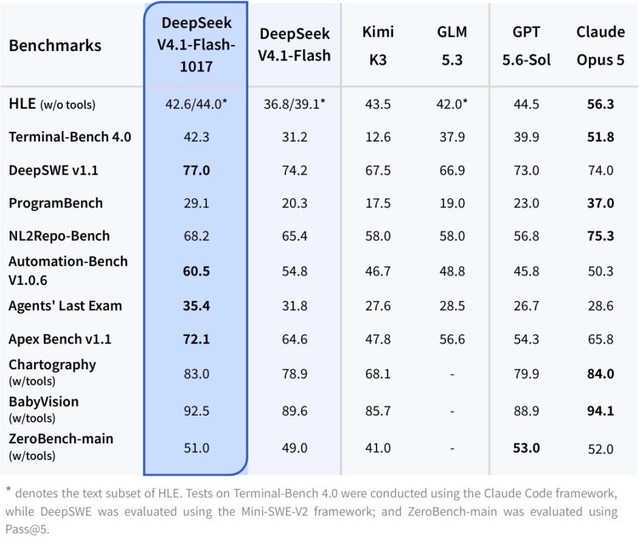
「DeepSeek-V4.1-Flash-1017」が無料で公開、コーディング系評価でGPT-5.6 SolやOpus 5を一部上回る性能
DeepSeek-AIは、画像とテキストに対応する7,630億(763B)パラメータのAIモデル「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開しました。
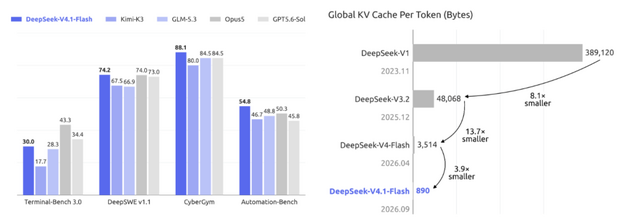
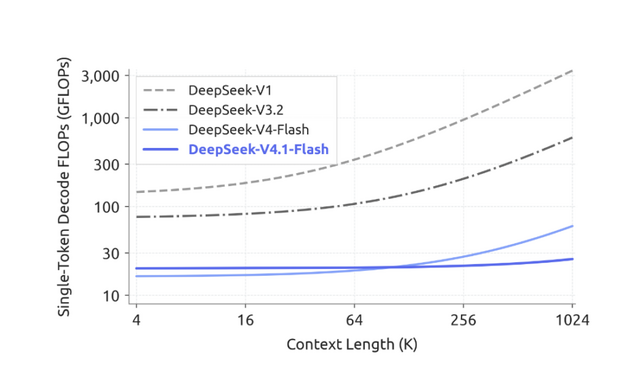
前モデルの改良版にあたり、推論、コーディング、エージェント機能、画像認識の精度が向上しています。さらに、処理時間と出力文字数を抑えることで、より高速かつ低コストな実行を実現しました。
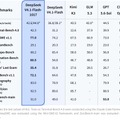
性能テストでは、ソフトウェア開発能力を測る「DeepSWE v1.1」や自動化タスクの「Automation-Bench」などで、GPT-5.6 SolやOpus 5などのモデルを抑えてトップの成績を記録しました。
DeepSeek-V4.1-Flash-1017
DeepSeek-AI
Paper | Hugging Face
脱獄済みPS5でローカルLLMを高速動作させるネイティブアプリ「PS5LM Plus」が登場
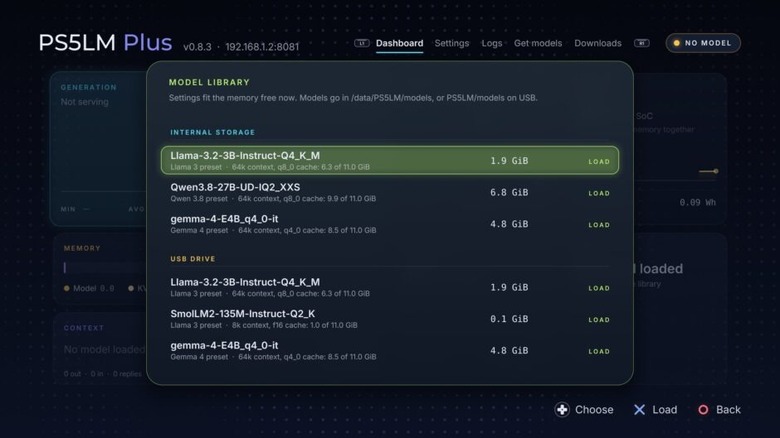
脱獄(ジェイルブレイク)済みのPlayStation 5で、ローカルLLM(大規模言語モデル)をGPU駆動で動かせるネイティブアプリ「PS5LM Plus」がGitHubで公開されています。
AI推論エンジン「llama.cpp」を移植したもので、Mert Cobanov氏が開発した「PS5LM」をフォークし、abhi245y氏がネイティブGPUアプリとして発展させたプロジェクトです。
従来はペイロードとしてCPUのみで1分間に約1トークンしか出なかった大型モデル(Qwen 3.8 27B、2ビット量子化)が、約20トークン/秒で動作したといいます。またGemma 4 E4Bは約61トークン/秒、Llama 3.2 3Bは約124トークン/秒で動作するとしています。
これを可能にした理由は、ペイロードではなくPS5のネイティブアプリとして動かすことで、本体の12GiBメモリとGPUが使えるようになったからです。PS5向けに移植されたRADVドライバーの上でllama.cppのVulkanバックエンドを動かし、12GiB全体を一つのGPUメモリ領域として扱えるようにしています。
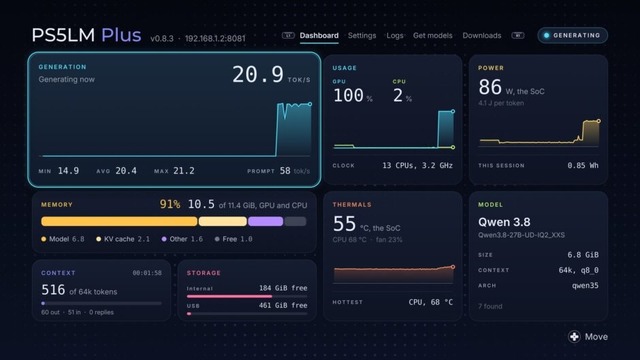
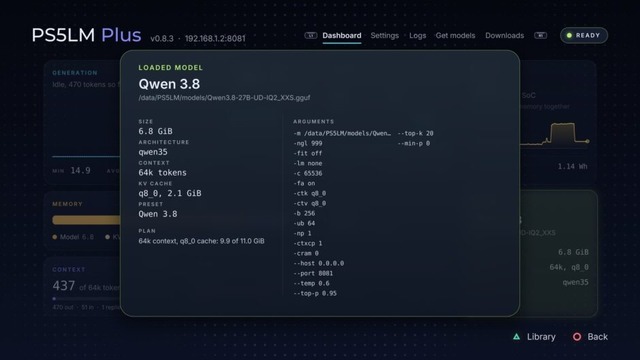
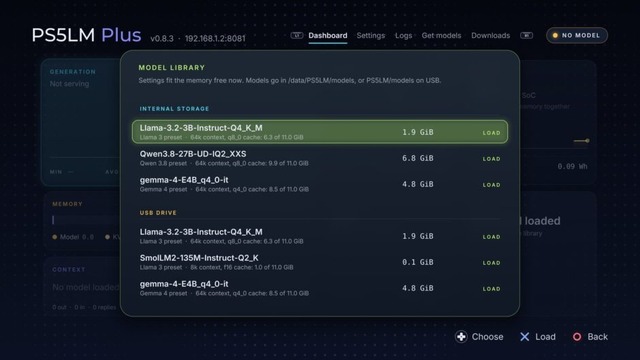
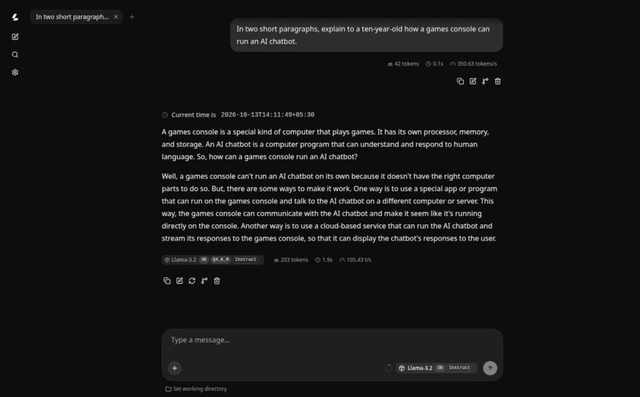
PS5LM Plus
abhi245y
GitHub