



生成AIグラビアをグラビアカメラマンが作るとどうなる? 連載記事一覧
iris-3b
10月はFLUX 3 ImageやKrea 3など、新しいのが発表されているが、前者はオープンとはいえ重みは未公開(入稿の数時間後にFLUX.3 Kleinが公開された)、後者はオープンかどうかは不明でアーリーアクセスのみ。そんな中、登場したのがSperidlabsのiris-3bだ。
Speridlabsはあまり聞いたことがなかったので調べると、ロボティクス、ゲーム、VFX向けの空間基盤モデルの開発を主に行っている初期段階のAIスタートアップだという。いきなり出してきたのがこのiris-3bというわけだ。
特徴は、
ピクセル空間直接生成: pixel-space式とも呼ばれるが、従来のVAEや圧縮潜在空間(Latent)を経由せず、直接すべてのピクセルを描画。画質のロスやテクスチャの歪みを抑え、約100万画素(1024×1024など)の画像を生成
パラメータ数:3B(モデル本体)+4Bのテキストエンコーダー(Qwen3-VL-4B-Instruct)
汎用ビジョンタスクへの対応:テキストからの画像生成だけでなく、同じピクセル空間のバックボーンをアーキテクチャ変更なしでタスクごとにファインチューニングするだけで、単眼深度推定や画像復元/超解像(4×)といった稠密タスクもこなす(1つのバックボーン、3つのタスク)。ファインチューニング済み重みも公式リポジトリに同梱されており、そのまま使える
ライセンス:Apache License 2.0
といった感じだ。pixel-space式はVAE式と比較して色にくすみがなかったり、良いところが多いものの、あまり見かけないのは、
VAEなし:画像を圧縮せず、そのままの画素(ピクセル空間)で直接計算するため、単純にメモリとパワーを必要として大変
画質・ノイズの誤魔化しが利かない:圧縮空間なら見逃してもらえる細かいゴマカシが一切通用せず、ピクセル単位の粗がそのままボケや破綻としてダイレクトに出るのでチューニングがシビア
つまり開発には手間暇がかかり、あまりやりたがらないということらしい。
ComfyUIはカスタムノードが必要。現在いくつかあるのだが、使い勝手がいいのは、
https://github.com/bani4kaskashka/Iris-3B-Comfy-Nodes
https://github.com/knishika62/Iris-3B-Comfy-Nodes-4steps
この2つ。1つは筆者がもう一方のリポジトリからforkしai-toolkitで作ったLoRAが使えるように改造したバージョンだ。ただしこの関係で、どちらか一方だけしかComfyUIにロードできない点は要注意!
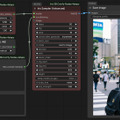
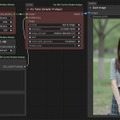
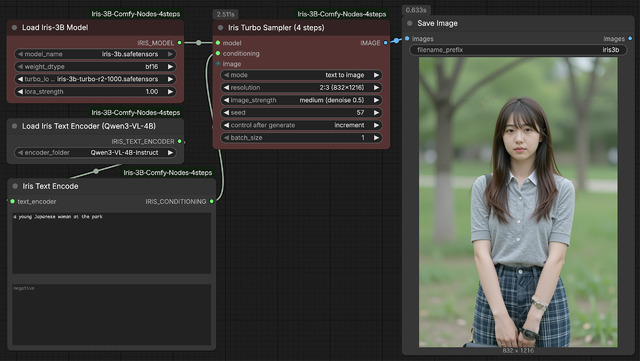
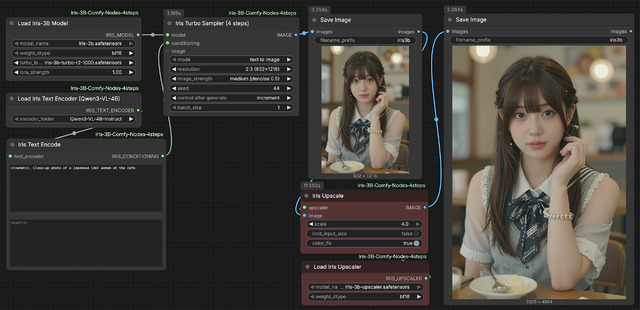
では筆者の作ったカスタムノードを使って実際ComfyUIのWorkflowと作例をご紹介したい。標準では50 stepsなので結構時間がかかる。
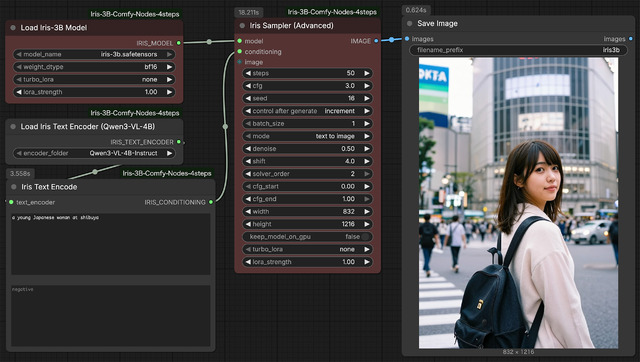
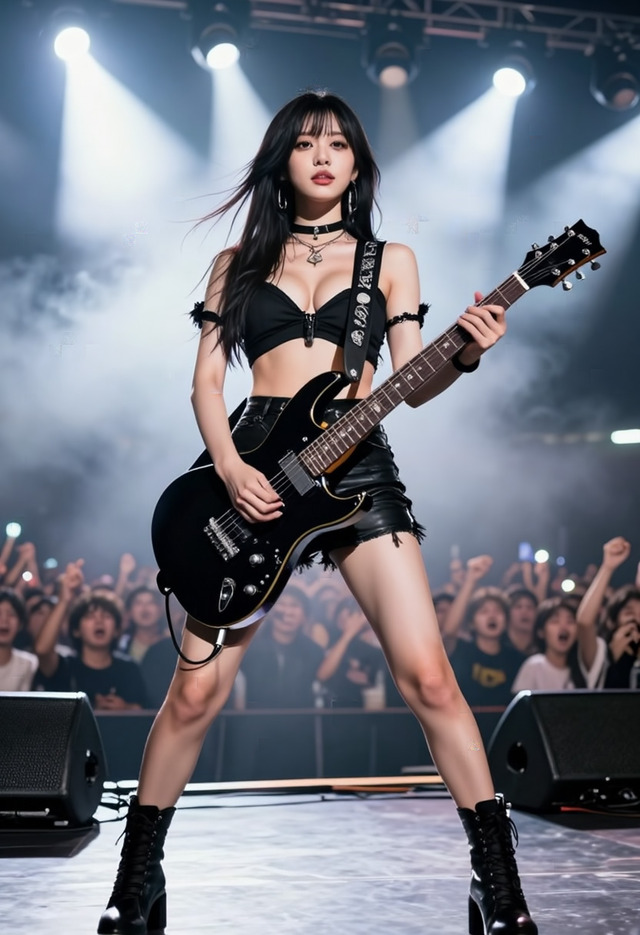 | 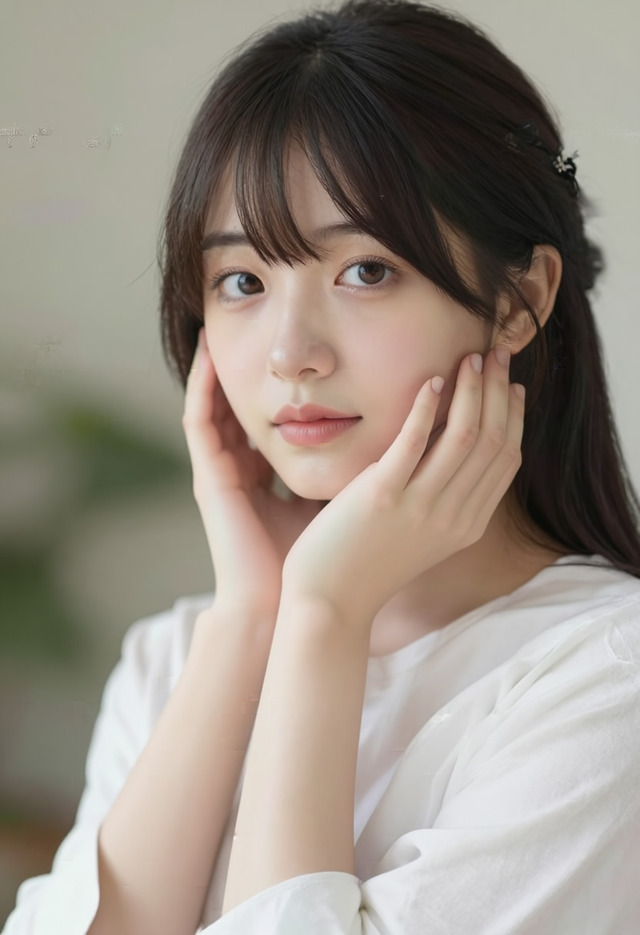 |
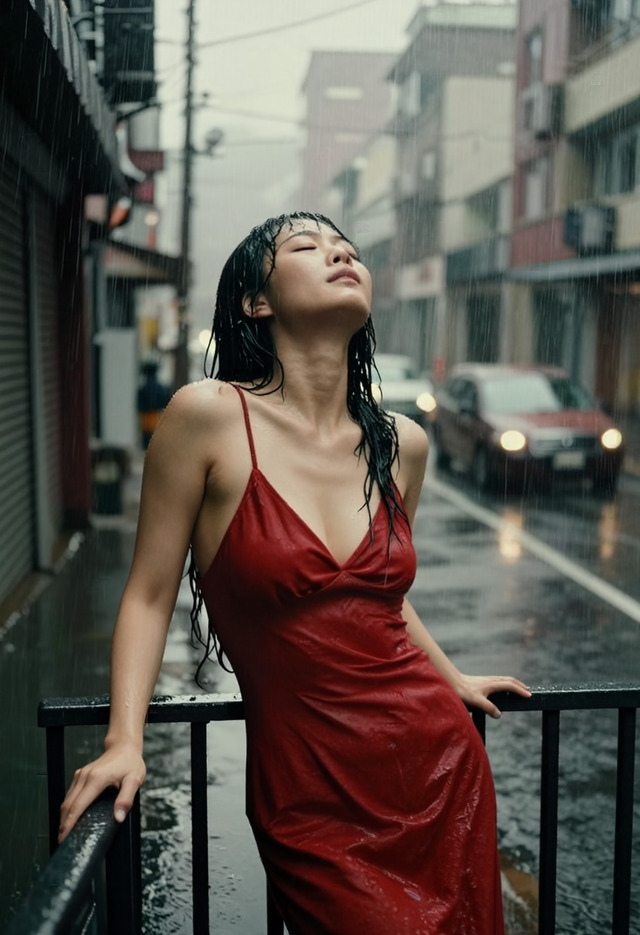 | 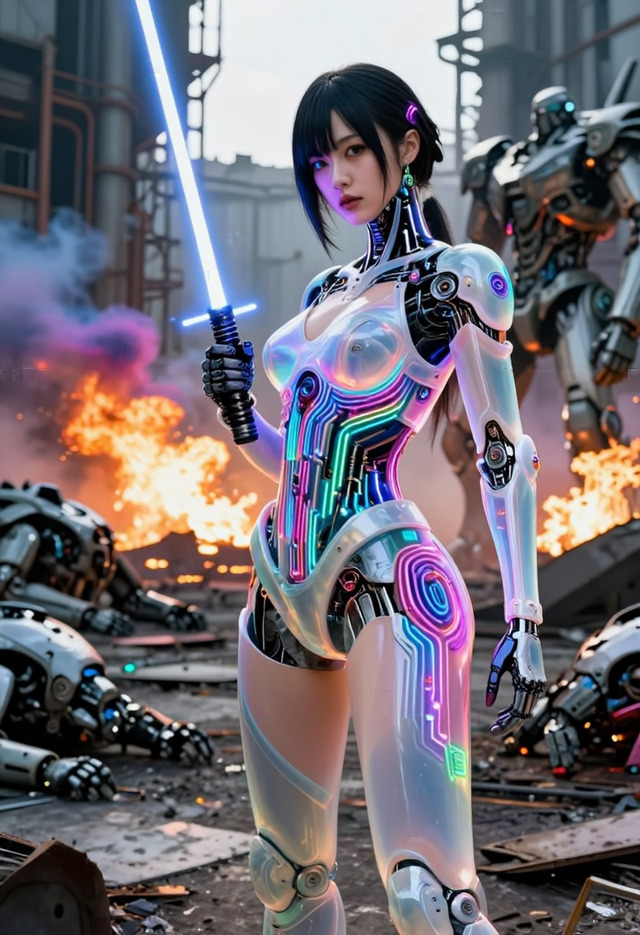 |
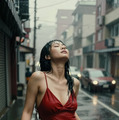
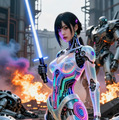
pixel-space式の特徴が右下アンドロイドの透明なボディやグラビアの水に映る光の反射に出てる感じだろうか。ただ良いことばかりではなく、3Bなのであまり難しいPromptはダメ。また指や体などが崩れやすい。
現在高性能なKrea2やZ-Image、そしてQwen-Image-2.1もあるので、あえてiris-3bを使う理由はないのだが、pixel-space式でちょっと発色などが面白く、興味のある人は是非試して欲しい。
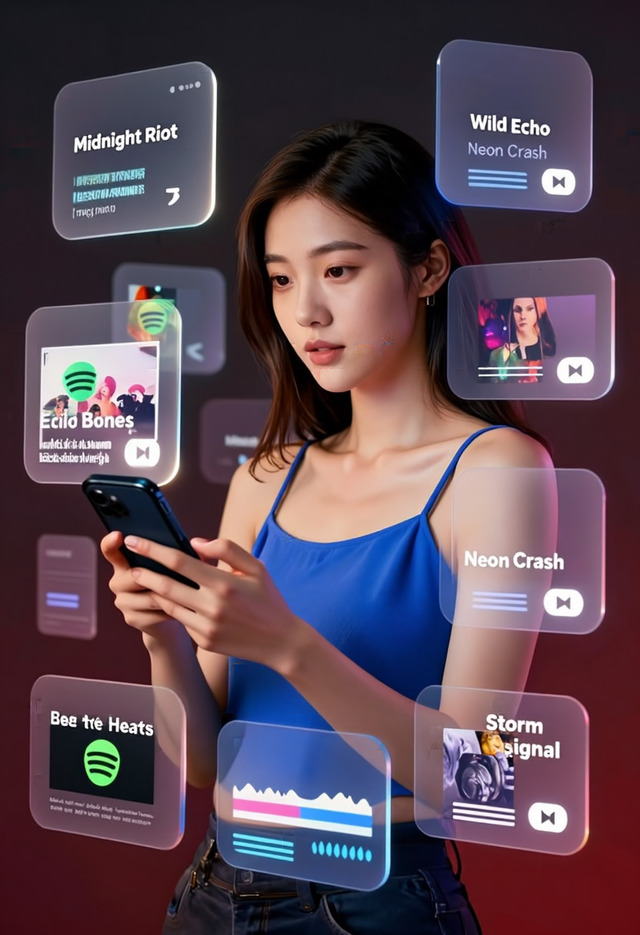
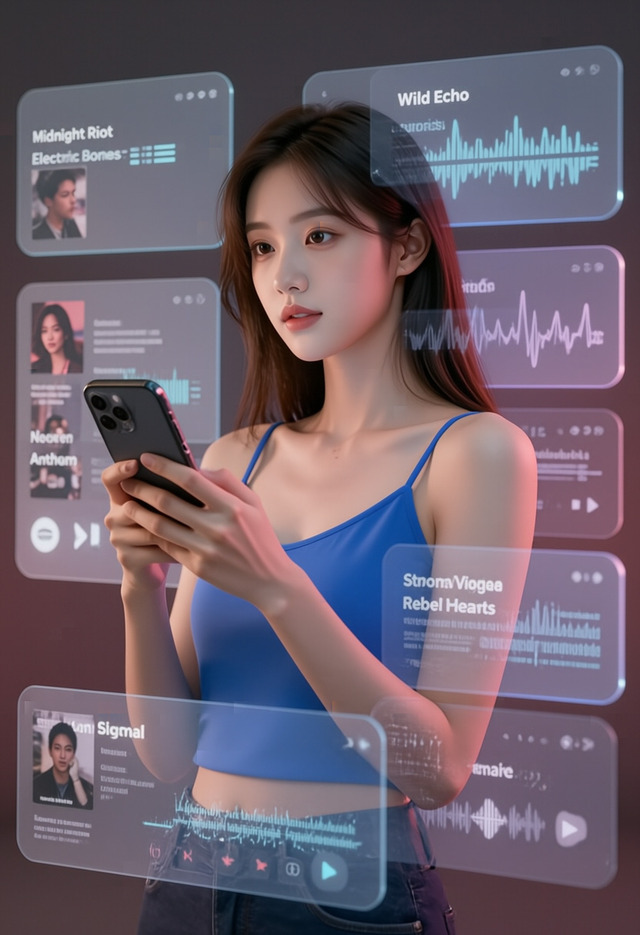
速く生成するには4 stepsのTurbo LoRAがあるのでこれを使う。iris-3b-turbo-r2-1000とiris-3b-turbo-r1-1500と2つあるが前者を使った方がいい。同じSeedでもstep数が異なるので絵柄は変わる(薄め?)ものの悪くない。
 |  |
加えてx4 Upscalerを標準装備。これは上記したようにpixel-space式だと全ピクセルが演算対象となるため解像度が上がると処理に膨大な演算を必要とするためベースは1MPに抑えられている。それを専用のUpscalerで解像度を上げる方式だ。
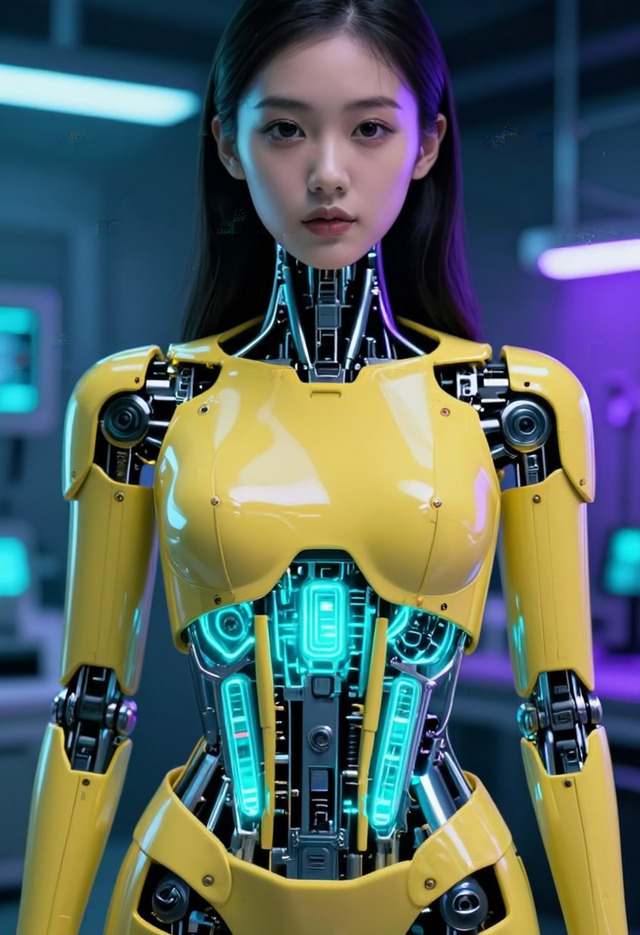 | 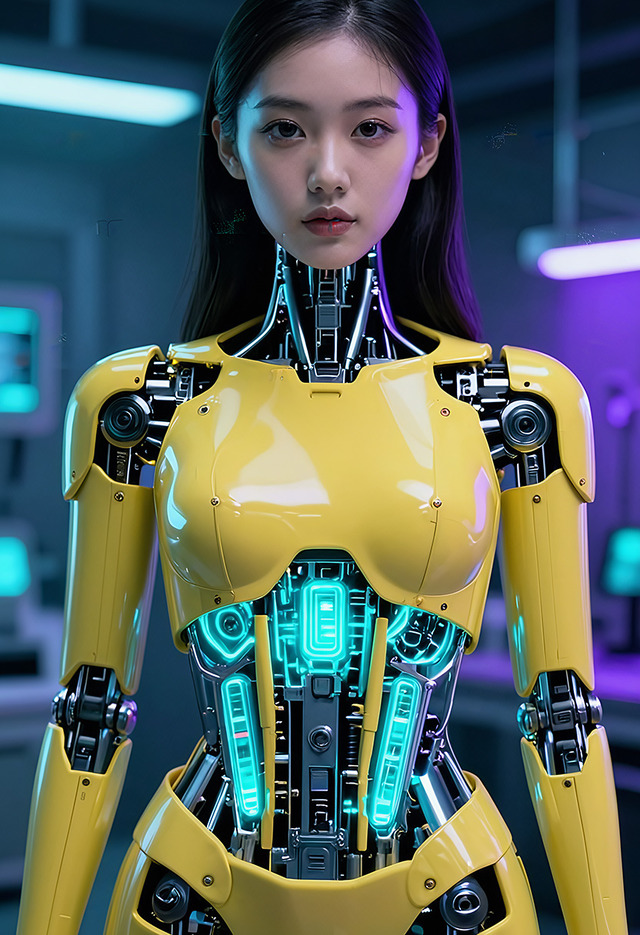 |
掲載する都合上、832x1216の元画像をx4 Upscalerで3328x4864にして、また832x1216に戻しているものの細部にかなり違いがあることが分かる。Seedでガチャリ、これ!といったのをUpscaleすればいいだろう。
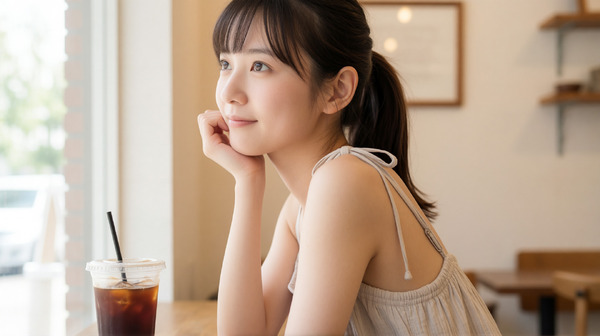
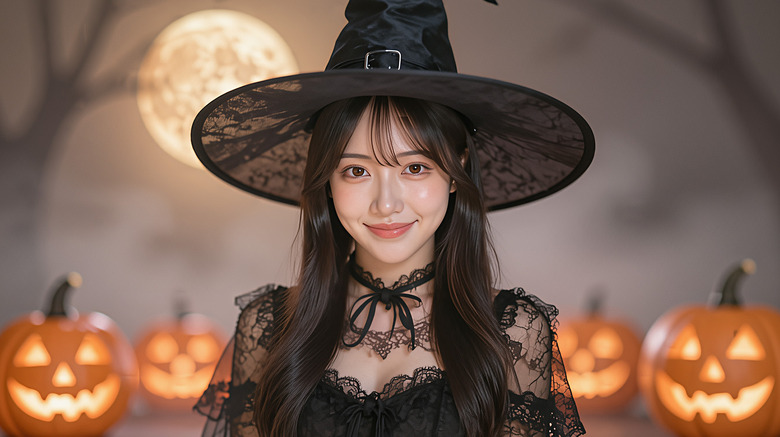
ai-toolkitはiris-3bのLoRAにも対応。早速顔LoRAを作った結果が実は扉とグラビアになっている(扉とグラビアはそれぞれ別の顔LoRA)。ただこのai-toolkitで作ったLoRA対応は、そのままではComfyUIで使えないため、筆者が作ったカスタムノードに機能追加している。
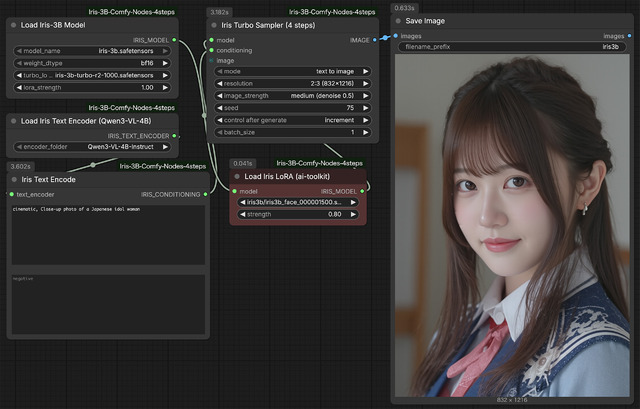
学習は標準設定のままだと3000 stepsになっているが、試した範囲ではdataset 10枚、1500 stepsで十分な感じだろうか。
最後はi2iだが、どうもi2iはうまく行かない。また4 steps Turbo LoRAは使用不可。50 stepsになるので仮に動いたとしても重い。
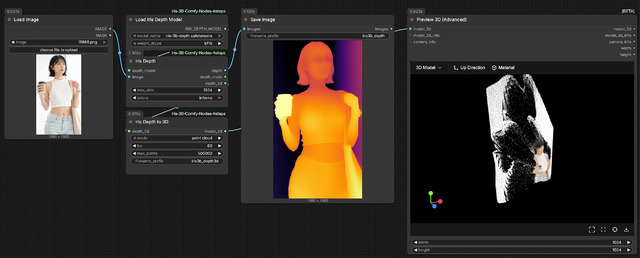
最後はDepthにも対応。重みは別途必要となる(iris-3b-depth.safetensors)。Workflowはこの様な感じだ。特に難しいことはない。終段、3Dっぽく出せるのが面白い。
今回締めのグラビア
今回締めのグラビアは、扉、グラビア共にiris-3bを使用。元々は832x1216なのだが、x4 Upscalerで3328x4864にした後、長辺を1920にリサイズしている。
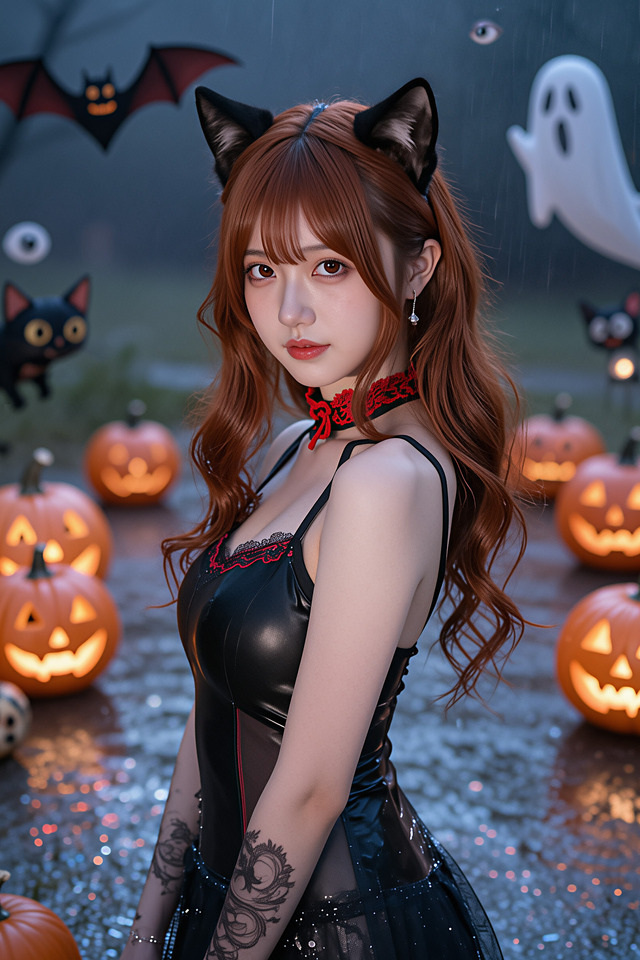
今年も早いものでもうHalloweenシーズン。多分次回も扉とグラビアのテーマは同じになるかな!? 冒頭に書いたFLUX 3 Imageが間に合えばいいのだが(本命はdevなのだが、Kleinが先に公開されました)……。